Mostrando entradas con la etiqueta x86. Mostrar todas las entradas

jueves, 2 de febrero de 2017

Intel Silvermont 22nm. Micro arquitectura. Etapas de Fetching – LowLevelHardware

En un artículo de ProfessionalSAT he hecho una introducción al nuevo procesador Atom Silvermont de 22 nm de Intel. Recomiendo la lectura de ese texto para estar familiarizado con algunos de los conceptos que son utilizados en el presente.

El mayor cambio en Silvermont respecto a los anteriores cores de la familia Atom es el cambio al procesamiento Out of Order (OoO) desde el primitivo concepto de ejecución In Order.

Ahora voy a describir, paso a paso, el pipeline de ejecución de Silvermont y las mejoras que aporta respecto a los antiguos cores (Bonnell 45 nm, Saltwell 32 nm).

Mejoras en las etapas de Fetch

Las etapas de fetching o carga de instrucciones son las primeras del pipeline de ejecución de cualquier procesador.

En Silvermont se ha llevado a cabo un rediseño profundo encaminado a alimentar adecuadamente de instrucciones a la nueva maquinaria de procesamiento out of Order.

Silvertmont_FetchFetch en Atom Silvermont 22 nm.

La predicción de saltos o Branch Prediction ha sido totalmente reconstruida de un modo distinto a los antiguos Atom. Se ha dividido en dos componentes independientes que actúan cada uno por separado y están situados en diferentes etapas del pipeline de procesamiento.

El primer componente es el Predictor de Fetching (Fetch Predictor). Es un Branch Target Buffer, un predictor de baja latencia y con una precisión elevada pero no extrema.

La unidad de Fetching carga cada ciclo 16 bytes de instrucciones desde la caché L1i con ayuda del L1 iTLB en los 6 Prefecth Buffers. Estos buffers aíslan las etapas de fetch de las posteriores etapas de decodificación X86 y así puede adelantarse a estas en el stream de instrucciones.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes. Gracias de antemano.

El que tenga dudas o aportaciones tiene para ello la sección de comentarios, intentaré responder a todos y con la máxima claridad. Los Blogs deben de ser lugares de intercambio y agradezco vuestro feedback.

AMD Bulldozer. Frecuencias finales. Actualizado – LowLevelHardware

Actualización 07 Septiembre 2011: Últimas noticias referentes al lanzamiento de Bulldozer y algunos datos técnicos extra al final del artículo.

InterlagosMCMUno de los primeros MCM Interlagos compuesto de 2 dies Bulldozer de 8 INT cores.

En la web de Gigabyte hemos encontrado las especificaciones finales de los procesadores basado en núcleos Bulldozer que próximamente saldrán a la venta.

Bulldozer_FXAMD Bulldozer. Por fin datos reales sobre los steppings comerciales.

Concretamente, la página en cuestión es la siguiente, correspondiente al soporte de CPUs de la placa base de socket AM3+ GA 990 FXA UD7.

En ella obtenemos alguna información extra sobre las nuevas CPUs de 32 nm de la serie FX.

Entre otros datos encontramos un TDP máximo de 125 W y la denominación B2 para el primer stepping comercial.

Bus Hyper Transport de 5.2 GHz

Todos los modelos ajustan su reloj HT3 a  GT/s. Sinceramente no veo razón para ello dado el excesivo ancho de banda ya disponible a las frecuencias de Thuban (Phenom II X6), GHz.

Obviamente la razón de esta alta frecuencia de 5.2 GT/s es comercial, marketing puro.

Este bus, en los procesadores de sobremesa, se utiliza para comunicar con el chipset y con los componentes periféricos. No es necesario un ancho de banda tan alto.

La especificación HT3 hace mención de frecuencias máximas hasta los 6.4 GHz (igual que el QPI de Intel), AMD ha sido prudente y ha dejado un margen para mejoras futuras.

Frecuencias base de AMD Bulldozer

La versión de 8 cores y 4 módulos (serie FX-8000) llegará hasta los 3.6 GHz nominales, desde ahí desplegará los modos Turbo.

Como comenté en el artículo anterior, AMD ha dotado a Bulldozer de un Turbo de dos fases:

640_5

Fase 1, All Core Boost: Todos los módulos (conjuntos de dos cores con su SIMD FPU Unit y los 2 MB de L2) aumentan su frecuencia por encima de la nominal si el TDP y la temperatura lo permite.

Se da en cargas de trabajo que implique a TODOS los cores, sea con carga parcial elevada o máxima 100%.

Fase 2, Max Turbo Boost: Si dos de los módulos (cuatro INT cores, dos SIMD FPUs y dos L2 de 2 MB) se hallan en estado Sleep C6 (power gated) el resto (los otros dos módulos) pueden incrementar su frecuencia hasta en 1 GHz sobre la nominal.

Esta implementación conlleva algunas consideraciones prestacionales extrañas y fastidiosas que detallaré cuando tenga hardware funcional comercial en las manos.

Se rumorean modos Turbo de hasta 1 GHz extra, es decir, hasta 4.6 GHz en carga 100% de 2 módulos, con los otros dos módulos en estado gated CC6.

En este caso tendríamos la siguiente capacidad de proceso:

  • 4 INT cores a 4.6 GHz en carga de enteros (compresión de datos por ejemplo).
  • 2 FPUs AVX de 256 bit en cargas de coma flotante AVX a 4.6 GHz.
  • 2 FPUs dobles de 128 bit en cargas de coma flotante SSE o AVX de 128 bit a 4.6 GHz.

Más información en breve.

Actualización 07 Septiembre 2011:

En primer lugar: Frecuencia máxima en modo Turbo Core: el modelo tope de gama FX-8150 (se enpecual con un FX-8170 para Q1 2012) será de 4.2 GHz con carga parcial de cores, probablemente con un máximo de 4 cores al 100%. Lo que no está nada mal manteniendo un TDP de 125W.

En segundo lugar: Nuevo evento de AMD en San Francisco para el día 13 de Septiembre:

Hanging out in San Francisco the week of September 12th? Not finding anything interesting?
AMD to the rescue. We'll be making an historic announcement, and want you to be a part of it.

AMD invites you to join us for an entertaining evening on the beautiful Yerba Buena Terrace at the St. Regis San Francisco. Spend the evening exploring the latest AMD technology, mingling with AMD executives and technology partners, all while enjoying cocktails and hors d'oeuvres. Be sure to arrive before 7:00pm to hear our big news first hand.

  When: Tuesday, September 13, 2011 RSVP
  Where: St. Regis Hotel, Yerba Buena Terrace, San Francisco
  Time: 6pm - 9 pm PDT
  RVSP: by September 9, 2011 at fusionzone.eventbrite.com (password: AMD)
Contact Information:
Heather J Lennon
Sr. Manager Public Relations, AMD
Heather.Lennon@amd.com
 

13 de Septiembre ¿Será el día de lanzamiento de Bulldozer?

Por último: Hoy AMD ha confirmado el comienzo de la venta de CPUs Interlagos de 16 cores para servidores a los integradores de sistemas. El primer chip con micro arquitectura Bulldozer.

"This is a monumental moment for the industry as this first 'Bulldozer' core represents the beginning of unprecedented performance scaling for x86 CPUs," said Rick Bergman, senior vice president and general manager, AMD Products Group. "The flexible new 'Bulldozer' architecture will give Web and datacenter customers the scalability they need to handle emerging cloud and virtualization workloads."

Para más información acerca de Bulldozer:

En múltiples artículos he analizado en detalle el diseño interno de BD 32 nm. Cito los más destacables:

AMD Bulldozer- HotChips23 – LowLevelHardware

AMD Bulldozer. Perspectivas – LowLevelHardware

La L3 cache multibanco en AMD Bulldozer. Actualizado – LowLevelHardware

AMD AGLUs, Bulldozer INT cores. Actualizado – LowLevelHardware

AMD Bulldozer. Primeros benchmarks. Actualizado – LowLevelHardware

AMD Bulldozer – ProfessionalSAT

La micro arquitectura de AMD Bulldozer. Actualizado – LowLevelHardware

Novedades y expectativas 2010. Actualizado – LowLevelHardware

AMD Bulldozer. Prestaciones estimadas – LowLevelHardware

Micro arquitectura AMD Bulldozer 2011. Actualizado – LowLevelHardware

Previo AMD Bulldozer. Actualizado – LowLevelHardware

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

AMD Bulldozer. Perspectivas – LowLevelHardware

Mucho se está hablando en los círculos informáticos acerca de la nueva micro arquitectura Bulldozer de AMD. Un diseño pensado para cargas de trabajo multithread y con pipelines de ejecución con mayor número de etapas para un alto potencial en frecuencia.

Orochi32nm_640AMD Orochi 32 nm 8 MB L2 y 8 MB L3.

En este artículo expondré algunas de mis opiniones sobre la micro arquitectura que va a marcar el futuro inmediato AMD de aquí a 2014.

AMD Bulldozer y el proceso de 32 nm HKMG SOI

En múltiples artículos he analizado en detalle el diseño interno de BD 32 nm. Cito los más destacables:

La L3 cache multibanco en AMD Bulldozer. Actualizado – LowLevelHardware

AMD AGLUs, Bulldozer INT cores. Actualizado – LowLevelHardware

AMD Bulldozer. Primeros benchmarks. Actualizado – LowLevelHardware

AMD Bulldozer – ProfessionalSAT

La micro arquitectura de AMD Bulldozer. Actualizado – LowLevelHardware

Novedades y expectativas 2010. Actualizado – LowLevelHardware

AMD Bulldozer. Prestaciones estimadas – LowLevelHardware

Micro arquitectura AMD Bulldozer 2011. Actualizado – LowLevelHardware

Previo AMD Bulldozer. Actualizado – LowLevelHardware

Bulldozer está fabricado por Global Foundries en el nodo de proceso de 32 nm HKMG (High K Metal Gate) SOI (Silicon On Insulator) lo que le dará unas buenas perspectivas de mejora de frecuencia y reducción de consumo con el paso del tiempo.

AMD a lo largo de su historia se ha caracterizado por ofrecer una continua mejora de su proceso de fabricación de semiconductores a los largo de la vida de cada nodo (para AMD unos 2 o 3 años).

Podemos decir que AMD saca al mercado los primeros chips en un nodo concreto (45 nm, 32 nm,…) cuando tiene unos yields (rendimientos de fabricación) mínimos (debido a la brutal presión competitiva de Intel) pero suficientes aún a costa de unas frecuencias de funcionamiento iniciales reducidas.

Con el paso de los meses AMD va mejorando paso a paso el proceso y se va reduciendo la disipación térmica, el voltaje y aumenta la frecuencia máxima de sus diseños.

GloFo32nm_640No es descabellado pensar en un 50% de mejora vs 45 nm para los 32 nm en AMD.

AMD Orochi Bulldozer. 4 módulos, 8 INT cores, 4 dual 128 FMACs y 2 MB L2

AMD Orochi va a rondar los casi 300 mm2 y está constituido por:

4 módulos completos.

4 bancos L3 de 2 MB y 16 vías (para un total de 8 MB L3 con 64 vías)

4 buses HT 3.0

2 controladoras DDR3 1866 MHz.

Un North Bridge.

El módulo en AMD Bulldozer

Frontend

Un módulo está integrado por:

2 INT cores con 2 ALUs y 2 AGUs, cada uno con su L1d de 16KB y 4 vías.

El Instruction Fetching desde la L1i compartida de 64KB y 2 vías.

La lógica de decoding de 4 vías con la Microcode ROM.

El circuitería de Branch Prediction.

La FPU doble de 128 bit FMAC (Fused Multiply Accumulate).

La unidad de control de caché que comprende las dos WCC (Write Combining Caches de 4 KB, una por INT core) que da acceso a la masiva cache L2 de 2 MB y 16 vías.

¿Qué podemos esperar de AMD Bulldozer?

Bulldozer al igual que Llano (la APU de 32 nm) se fabrican en el nuevo proceso y por ello sufrirán inicialmente de unas frecuencia máximas no muy elevadas.

Llano se ha estrenado a frecuencias máximas de 2.9 GHz, ahora está previsto que llegue al mercado una versión desbloqueada a 3.1 GHz con overclocks “sencillos” a 3.6 GHz.

Los cores de un Phenom II (al menos en los últimos steppings de 45 nm) llegan con relativa facilidad a los 4 GHz. A Llano esta frecuencia le queda lejos y eso que está fabricado en el siguiente nodo que debería proporcionar una mejora teórica de un 20% en frecuencia.

AMD 32 nm vs 45 nmDisipación térmica: AMD 45 nm vs 32 nm.

Recordemos que cuando AMD empezó a fabricar CPUs de 65 nm también padeció problemas claros de escalado de frecuencia, en concreto los primeros AMD K8 Brisbane funcionaban a 2.6 GHz cuando los “antiguos” K8 90 nm funcionaban sin problema a 3 GHz.

O pensemos en AMD Phenom Barcelona, fabricado en 65 nm en 2007 y que salió al mercado a unos meros 2.3 GHz cuando los K8 de la época (todavía de 90 nm) funcionaban a 3.2 GHz (Athlon 64 X2 6400+).

Conclusiones

Con esta coyuntura en mente podemos pensar lo siguiente según los diversos rumores y leaks que circulan:

Bulldozer, inicialmente en su configuración completa (Orochi) para socket AM3+ es deseable que ronde los 3.5 GHz nominales con carga 100% en los 8 cores y que gracias al Turbo logre frecuencias con carga de cores parcial (mitad de cores al 100%) rondando los 4 GHz.

AMD postula precios de unos 300 dólares para el top bin de Orochi, eso le sitúa en la banda de precios del Intel Core i7 2600K Sandy bridge: En mi opinión sería un éxito rotundo de AMD el posicionarse competitivamente en este nivel de precios.

A mí personalmente me cuesta creerlo pero sería una excelente noticia para la sana competencia en el sector.

En cualquier caso estamos a la vuelta de la esquina del lanzamiento previsto para Bulldozer, será en Septiembre si no hay cambio de planes. Para AMD sería una excelente noticia, y de paso dispararía su cotización bursátil, bastante deprimida tras los momentos gloriosos de los K7 y K8.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

La L3 cache multibanco en AMD Bulldozer. Actualizado – LowLevelHardware

Poco a poco se acerca la comercialización de los procesadores basados en la nueva micro arquitectura de AMD prevista para el 7 de junio. Actualización: finalmente llegará al mercado en Septiembre según los últimos roadmaps.

Bulldozer_32nm_640

Conforme pasan los días se va filtrando nueva información sobre su estructura interna y también algunos datos acerca de su rendimiento, o por lo menos del rendimiento de algunos Engineering Samples.

Bullzorer_ModuleBajo el módulo con su L2 de 2 MB se observa el banco de L3 de 2 MB y 16 vías.

En este artículo hablaré sobre la estructura de la caché L3 en Bulldozer y sobre su funcionamiento.

La caché L3 multibanco: 4 x 2 MB

AMD ha diseñado una caché L3 particionada en 4 sub arrays de 2 MB y 16 vías cada uno. la capacidad total en el chip de 4 módulos y 8 INT cores es de 8 MB y 64 vías de asociatividad.

El diseño es exclusivo, la L3 no incluye los datos presentes en la L2 de 2 MB de cada módulo y en cambio es una Victim Cache, donde se alojan las páginas desalojadas desde L2.

L3_1La frecuencia estimada para la L3 es de 2.4 GHz.

Con una frecuencia estimada en 2.4 GHz los anchos de banda son los siguientes:

  • 307.2 GB/s en lectura gracias a sus dos accesos por ciclo de 128 bit y por módulo.
    2 400 000 ciclos/s x 4 módulos x (2 accesos/ciclo x 128 bit) = 2 457 600 000 bit / 8bits/1 byte = 307 200 000 bytes/s = 307.2 GB/s
  • 153.6 GB/s en escritura gracias al acceso de 128 bit por ciclo.
    2 400 000 ciclos/s x 4 módulos x 128 bit = 1 228 800 000 bit / 8bits/1 byte =152 600 000 bytes/s = 153.6 GB/s

Por lo que se desprende de este documento, la caché L3 está conectada con cada módulo Bulldozer mediante dos buses de lectura de 128 bit y un bus de escritura de 128 bit. Se me antoja una mejora absolutamente espectacular respecto a anteriores diseños de AMD (un Phenom II X6, por ejemplo, solamente cuenta con un bus de 64 bit por core hacia y desde la L3 de 6 MB y 24 vías). De ahí sus mediocres resultados en este apartado.

Especulación 1. Espero latencias L3 elevadas en Bulldozer.

Teniendo en cuanta que la latencia efectiva L3 (load to use) es aditiva con la de los demás niveles y que la latencia L2 ya es conocida y va de los 18 a los 20 ciclos no será nada extraño que la latencia L3 efectiva en Bulldozer ronde los 50 ciclos.

Otro dato que apunta en la misma dirección es que se mantiene el diseño asíncrono con buffers de sincronización de Shanghai (Phenom II 45 nm), con una frecuencia de cores variable por los modos Turbo desde los 2.8 hasta los 3.5 GHz, será difícil conseguir bajas latencias L3.

Por último, una asociatividad tan elevada, 64 vías, aunque aumenta la tasa de aciertos L3, tampoco ayuda en cuanto a la latencia ya que hay que examinar 64 localizaciones cada vez en busca del dato o instrucción.

8 MB = 4 bancos de 2 MB y 16 vías

Una solución elegante que podría haber adoptado AMD consiste en que cada core tenga una latencia reducida de acceso hacia su banco local L3, es decir, que tenga “privilegio” de acceso a este banco y por ello mayor ancho de banda en GB/s y menor latencia en ciclos.

Bulldozer_32nm_L3_640

Esto sólo lo descubriremos en la práctica en cuanto le “echemos el guante” a un stepping final (comercial) de Bulldozer, lo tendremos el día 7 de Junio. Actualización: Bulldozer estará finalmente disponible en Septiembre si se cumplen las previsiones.

Conclusiones

AMD ha diseñado una caché L3 que marca un punto de partida desde sus actuales diseños de 45 nm y 6MB con 24 vías (Shanghai o Istambul). En Bulldozer son 4 bancos de 2 MB y 16 vías para un total de 64 vías.

Tengo ganas de probar un stepping final para ver si la latencia a cada uno de los bancos es diferente o por el contrario idéntica. Si existe una controladora de L3 para los 4 bancos será una latencia constante y elevada… en cambio, si cuenta (como Sandy Bridge) con una controladora L3 por cada banco de 2 MB pueden haber sorpresas.

En todo caso y con una L2 con 18 – 20 ciclos es difícil lograr latencias l3 muy recortadas. E s lógico esperar 10 ciclos más de latencia que en Sandy Bridge como mínimo (la L2 de SB tiene pipelines de 10 etapas Load to Use).

Destaca su optimización pensando en una baja disipación térmica y sobretodo en un consumo reducido, por ello su frecuencia rondará los 2.4 GHz y su voltaje estará sobre los 1.15 a 1.20 V efectivos. Es un diseño convencional, de bus con conectividad total entre todos los agentes, cada módulo Bulldozer y cada slice L3.

Hay que ser consciente del camino absolutamente divergente que ha adoptado Intel con Sandy Bridge 32 nm. La L3 es síncrona a los cores y funciona a la misma frecuencia que estos. Con ello consigue una bajísima latencia y un ancho de banda astronómico. Los diferentes bancos L3 se comunican entre sí mediante un ring bus bidireccional que aporta un gran ancho de banda y un funcionamiento “sencillo” a estos niveles.

Echad un vistazo a la web de mi nueva empresa, un proyecto de gran envergadura que llevo preparando hace más de un año.

Os lo recomiendo para diseño de sistemas de altas prestaciones optimizados al límite:

ip16_texto_300px_blanco422222

Allí tenéis a vuestra disposición el formulario de contacto, para consultas sobre este artículo hacedlo más abajo en la sección de comentarios.

Y mi nuevo Blog de contenido muy técnico y actualizado donde encontraréis artículos míos sobre hardware, procesadores y sistemas y también otros posts de expertos programadores e informáticos sobre otros temas de actualidad:

infromaticapremium-blog422222

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Microarquitectura Intel Sandy Bridge. Parte 1. Actualizado - LowLevelHardware

Estos días Intel está celebrando en San francisco el IDF 2010 (Intel Developer Forum), entre multitud de temas relacionados con el futuro de la industria de semiconductores ha hablado de Sandy Bridge.

SandyB_Nehalem_WestmereSandy Bridge tiene menor superficie de die que Nehalem pese a contar con una GPU con 12 SPs.

En estos artículos me voy a centrar en los cambios microarquitecturales de Sandy Bridge sobre la anterior generación de cores de Intel, Nehalem 45 nm y Westmere 32 nm.

En esta primera parte abordaré varios aspectos:

  • Intel Tock 2010. La aplastante cadencia del gigante de los semiconductores.
  • Sandy Bridge Ring Bus. La nueva organización de la comunicación inter die.
  • El System Agent de Sandy Bridge. El Uncore o North Bridge.
  • El Front End de Sandy Bridge. Las primeras etapas del pipeline.
  • El mecanismo de Branch Prediction, tan críticamente importante en algoritmos de enteros.

Intel Tock 2010

Sandy Bridge es un cambio profundo respecto a la ya excelente y exitosa microarquitectura que Intel puso en juego en 2008 con Nehalem, los cores que mueven los chips Core i7.

SB_TOCK_630 Sandy Bridge es el Tock de 32 nm tras Nehalem y Westmere.

Poco había que mejorar en la arquitectura de los cores Nehalem, ya que Intel lidera en prestaciones en todos los campos… pero los grupos de ingeniería en Intel no podían quedarse dormidos en los laureles (como desafortunadamente hizo AMD tras su excelente core K8).

PIN_630 La próxima generación: Intel Sandy Bridge.

Por ello han procedido a un exhaustivo y profundo rediseño:

Desde el Front End, hasta las unidades de ejecución, el Branch Prediction e incluso las unidades Load – Store. También se ha modificado la arquitectura de la cache L3 dividiéndola en bancos de 2 MB por core y la interconexión interna de las diferentes partes del procesador.
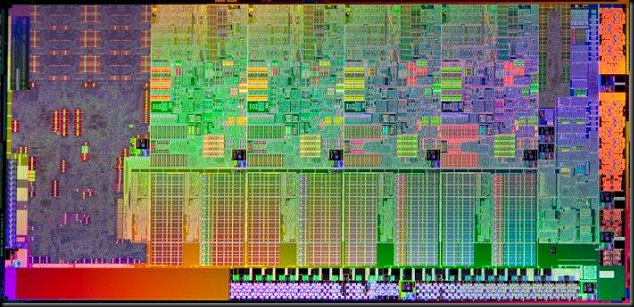
SandyBridge_Die_2_630 (2) Die de Sandy Bridge quad core 32 nm.

El Ring Bus que ahora hace de ruta de comunicación entre todas y cada una de las partes del procesador:

  • cores
  • Bancos de L3 de 2 MB
  • System Agent -Uncore o North Bridge-
  • GPU integrada
  • Video decoder – encoder

Es, a mi modo de ver, uno de los cambios más significativos respecto a diseños anteriores (Westmere y Nehalem).

SB Intel no ha dejado nada al azar con Sandy Bridge.

Sandy Bridge Ring Bus

Intel ha dotado a Sandy Bridge de un novedoso y extremadamente rápido sistema heredado de su hermano mayor Nehalem EX, un anchísimo y eficiente Ring Bus de comunicaciones para coordinar todas las transacciones de datos inter die.
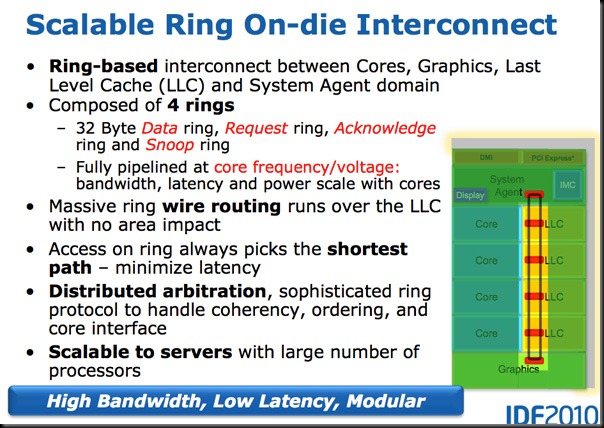
SB_RING Implementación del Ring Bus en Sandy Bridge.

El ancho de banda del bus de datos es de 32 bytes, es decir, 256 bits y su topología es en anillo, es decir, escala con el número de cores y bancos de L3. A mayor número de cores o bancos de L3 mayor ancho de banda agregado.

Lo más llamativo del bus en anillo de Sandy Bridge (y Nehalem EX) es su implementación respetuosa con el consumo y el área de die, me explico:

Todos recordamos el famoso procesador Radeon HD 2900 de ATI con un ring bus de 512 bits, que debido a su desmesurada disipación térmica y consumo no pudo competir con sus análogos de nVidia hasta que ATI lo eliminó sustituyéndolo por una arquitectura convencional en su serie Radeon HD 3800.

En Sandy Bridge Intel ha utilizado power gating y clock gating extensivamente, además de aplicar un voltaje bajísimo al ring bus para conseguir una disipación térmica muy baja.

Por otro lado, es un dato muy importante, según los ingenieros de Intel, no ha representado un incremento de área ya que la infinidad de conductores necesarios para el Ring Bus se enrutan por otras capas del diseño bajo la caché L3.
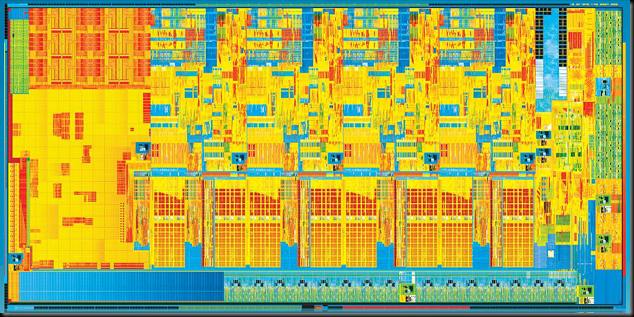
SB_Die_630 Sandy Bridge quad core para socket LGA 1155.

Lo que se consigue con este ring bus es aumentar de manera lineal el ancho de banda agregado (total) con el número de Ring Stops (cores, bancos de L3, …) consiguiendo una escalabilidad perfecta.

Como he comentado en artículos anteriores, además se consigue una muy notable bajada de latencia de la caché L3, del orden del 30% (!!) que ya de por sí en Nehalem y Westmere era realmente rápida.

Ahora nos encontramos en los veintitantos ciclos de latencia respecto a los 38 - 42 ciclos de Nehalem y algo más en Westmere.

El System Agent de Sandy Bridge

El anteriormente denominado Uncore, Nocore o North Bridge ahora no incluye ya la caché L3, por lo que la L3 es síncrona a los cores, con lo que aumenta su frecuencia aumentando su ancho de banda y disminuye su latencia.

SB_SASandy Bridge System Agent.

El System Agent se encarga de controlar todas las transacciones entre los cores, la GPU integrada, los coders y decoders de video integrados con:

  • La memoria principal a través de las dos controladoras DDR3.
  • Las GPUs externas a través de los puertos PCI Ex.
  • Los dispositivos externos a través del DMI vía chipset.

Para mejorar la disipación térmica y reducir el consumo en sistemas portátiles integra la controladora de video y la PCU (Power Control Unit) encargada de gestionar los voltajes y las frecuencias de los cores así como los Turbo Modes y los modos de ahorro de energía y el Power Gating a nivel de cores.

El Front End de Sandy Bridge

El Front End es la parte del microprocesador encargada de suministrar la secuencia de instrucciones X86 desde la caché L1i (cache L1 de instrucciones) y de descodificarlas a un formato más manejable (micro operaciones, uops).

Intel, en este apartado ha roto con el pasado y ha desarrollado un Front End revolucionario.

Estas instrucciones ya descodificadas se encuentran en un formato interno y propietario, son llamadas uops (micro operaciones) y son características de cada microarquitectura.
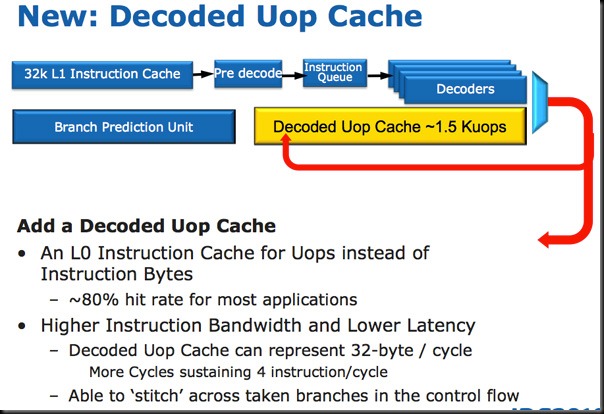
SB_uopcache uop cache en Sandy Bridge, una especie de L0i.

Sandy Bridge mejora el Loop Stream Buffer de Westmere 32 nm que contenía hasta 28 uops con una estructura dedicada llamada Decoded uop Cache que es capaz de almacenar unas 1500 uops (sobre unos 6 KB de capacidad) y que actúa a modo de caché L0 de instrucciones suministrando a las etapas de ejecución fuera de orden instrucciones con menor latencia que la L1i de 32 KB y además manteniendo más fácilmente la cadencia de 4 uops / ciclo.

Además el Fetching desde esta nueva L0i se hace en paquetes de 32 bytes / ciclo, aumentando el llenado efectivo de las unidades de ejecución que le siguen en el pipeline.

Intel cita la tasa de aciertos de esta L0i en un 80% en código de aplicaciones típicas. En el caso de acierto (que como vemos es un 80% de las veces) se desconectan las etapas de Fetch y Decoding con el consiguiente ahorro energético y de temperatura (muy notable ya que el consumo de estas etapas es muy alto en CPUs de arquitectura X86).

Entre los mecanismos que forman parte integral del Front End nos encontramos con la lógica y SRAMs de Branch Prediction encargado de cargar en el orden correcto la secuencia de instrucciones después de una bifurcación en el código (Branch) decidiendo si la condición se cumple o no mediante lógica y algoritmos de especulación y distintas tablas de datos de historia precedentes.

El mecanismo de Branch Prediction

Sandy Bridge ha mejorado notablemente el manejo de Branches en el código, aumentando la tasa de acierto. Los ingenieros de Intel han optimizado el diseño pero permaneciendo en el misma footprint (la misma superficie).

SB_Branch Optimización del Branch Prediction en Sandy Bridge.

Utilizando técnicas de compresión sin pérdidas en Sandy Bridge se almacenan más datos de historia en la misma capacidad que en Westmere por lo que efectivamente se han ampliado al doble el número de entradas en las tablas de Targets, elevando con ello la tasa de aciertos de los algoritmos respecto a Westmere.

Estoy deseando probar Sandy Bridge en algoritmos ajedrecísticos.

Nos vemos en la segunda entrega.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Novedades y expectativas 2010. Actualizado – LowLevelHardware

Estamos en una época de transición, tanto AMD como Intel presentan en breve novedades importantes que incluyen reformas microarquitecturales profundas.

GloFo32nm El proceso de 32 nm va a traer muchas novedades al portafolio de CPUs de AMD.

Ya he escrito varios artículos sobre los nuevos Intel Sandy Bridge 32 nm:

y sobre los esperadísimos AMD Bulldozer de 32 nm:

Roadmap de AMD para 2011.Roadmap de AMD 2010. Ontario 32 nm.

AMD_CPU_roadmap_2010Roadmap de AMD para 2011.

AMD tiene previsto para finales de este año (Q4 2010) su nuevo procesador Ontario. Un dual core con GPU DX11 integrada. Los cores de Ontario son los nuevos Bobcat de los que hablé en un pasado artículo.

AMD_Notebook_Roadmap_2010_1[1] Ontario formará parte de la plataforma Brazos.

Si el proceso de 32nm SOI de Global Foundries evoluciona según lo esperado será el primer procesador fabricado en este nuevo nodo por AMD.

amd_bobcat_coreAMD Bobcat core. En Ontario habrá dos de ellos además de una GPU DX11 integrada.

AMD posiciona a Bobcat como competidor de los anémicos cores de los procesadores Intel Atom. Según AMD sus prestaciones serán netamente superiores.

Contará con dos pipelines de enteros y una unidad FPU simplificada con dos pipelines. Su TDP por core irá desde  algo menos de 1 W hasta los 10 W en función de las frecuencias y voltajes aplicados.

AMD_fusionAMD Fusion, su primer representante de 32 nm será Ontario.

En mi opinión serán cores capaces de mover Windows 7 con cierta alegría y gracias a la presencia de la GPU integrada DX11 (basada en la arquitectura ATI Radeon HD 5000) espero prestaciones decorosas en video HD y juegos. Todo ello con un consumo que permitirá su integración en netbooks de gama alta.

Llano 32 nm, retrasado a principios de 2011.

El segundo procesador de AMD para 2010 y fabricado igualmente en 32 nm por GloFo iba a ser Llano según los roadmaps de AMD. Desafortunadamente y debido a retrasos en su diseño ha sido pospuesto a principios de 2011. Será la CPU destinada a sustituir los Phenom II X2 y X4 de 45 nm.

AMD_Desktop_Roadmap_2010_20 La plataforma Lynx contará con procesadores Llano.

Será un procesador con GPU integrada (también DX11) más potente que la de Bobcat (se rumorean 400 – 480 SPs) y dos o cuatro cores derivados de los que encontramos actualmente en los Phenom II.

AMD_Llano_coreDie de uno de los cores de Llano 40 nm.

Cada core contará con 1 MB de L2 privada, no habrá caché L3 compartida y las controladoras de memoria (2 canales de DDR3) darán servicio a los 4 cores y a la GPU.

AMD_K10.6_32nm Otra vista de uno de los cores de Ontario.

Los cores presentan numerosas mejoras respecto a los conocidos K10.5 de Phenom II, en el análisis del  die ya se aprecian bastantes reformas destinadas a mejorar el rendimiento en enteros y en FPU.

LlanoPowegate[1] Mejoras en los cores de Llano.

  • La ventana de instrucciones ha aumentado de 72 a 84 entradas (desde los K10.5).Es utilizada por el hardware OOO (Out of Order Execution) para extraer paralelismo y ejecutar en el orden óptimo el stream de instrucciones con la máxima ocupación de las unidades de proceso.
  • Se ha dotado a la unidad de enteros de hardware para la división.
  • Se ha reducido la latencia de las instrucciones de coma flotante FPU.
  • Se ha mejorado el prefetch de datos para aumentar las tasas de aciertos de las cachés L1 y L2.
  • Se ha reducido las latencias de transición entre los estados de caché y ha aumentado la velocidad escritura en memoria.
  • Como en todo procesador actual se ha trabajado duramente en reducir su consumo, ampliando el clock gating y dotándolo de core gating.

AMD_Lano_cut Fotografía parcial del die de AMD Ontario 32 nm.

Se observan los cuatro cores cada uno con 1 MB de L2 y abajo la GPU integrada, la fotografía está cortada por su parte inferior.

Llano32nm AMD Llano 32 nm.

Aunque a mi modo de ver, si AMD diseña Llano con un número de SPs elevado (más de 320) estará claramente limitado por su ancho de banda de memoria (2 canales DDR3 1333 para gráficos es poca cosa…)

Veremos cono se plasma todo en los diseños definitivos, a mediados de Agosto AMD desvela la microarquitectura detrás de Bulldozer, os mantendré informados.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Athlon II X4, IBM Power 7 e Intel Nehalem EX – LowLevelHardware

Desde hace ya unos años los fabricantes de semiconductores están dando un giro copernicano a su estrategia de prestaciones a toda costa a cambio de una moderación clara en la disipación térmica de sus diseños.

AMD Athlon X4

Ya en un artículo anterior de Junio 2009 hablé ligeramente sobre estos nuevos procesadores de AMD. Su comercialización está prevista para Septiembre.

PhenomII_NO_L3AMD Athlon X4 de 45 nm. Cuatro núcleos con 512 KB de L2 cada uno.

AMD ha decidido reducir costes eliminando la caché L3 de 6 MB de los Phenom II X4 y prescinde además de tres de los enlaces HT (HyperTransport) quedando uno para comunicación con el chipset. La superficie estimada para este procesador ronda los 160 – 170 mm2 proporcionando una gran reducción de costes respecto a Phenom II.

Los precios serán muy reducidos y habrá variantes Triple core con uno  de los procesadores desactivado:

Gama de procesadores Athlon II X2, X3 y X4.

Se rumorean precios inferiores en unos 25€ al quad más barato de Intel. inicialmente su frecuencia máxima será de 2.6 GHz, pero sin duda será sencillo dejarlos sobre los 3.8 GHz con un trivial overclock.

La era del performance per watt

Intel, con su “right hand turn”, acabó con su microarquitectura Netburst (la línea Pentium 4) cancelando el procesador Tejas de 90 – 65 nm (el cuarto integrante de la saga) y dando paso a la exitosa (y derivada de la anterior microarquitectura Pentium III) línea Core 2 Conroe 65 nm y Penryn 45 nm.

Ahora es IBM quien adopta esta línea de moderación en consumo huyendo de sus anteriores speed demons (IBM Power 6). Power 7 será un diseño mucho más equilibrado, con ocho cores en un die y con la novedad de utilizar eDRAM para el último nivel de caché (con el doble de densidad por mm2).

Power6 IBM Power6, un masivo dual core con un consumo eléctrico desmesurado y casi 5 GHz.

Probablemente contará con 24 MB de eDRAM para los ocho procesadores con SMT de dos o quizás cuatro vías (para un total de 16 o 32 threads por chip). El ancho de banda por socket excederá los 300 GB/s de Power6 (ya de por sí todo un record).

Personalmente espero un rendimiento sobresaliente para estos procesadores (no como en su día para el Power6, que no me gustó nada cuando en su día su microarquitectura fue hecha pública) que a mi juicio retoman una línea de trabajo más lógica para IBM, ya que el mundo x86 está presionando fuertemente.

Intel Nehalem EX

El rival del anteriormente mencionado IBM Power7 será un procesador de ocho cores con SMT de dos vías para 16 threads por chip. Contará con 24 MB de L3 compartida y cachés L2 de 256 KB para cada core.

Se alojará en el nuevo socket 1566 LGA. Ya hablé de este procesador en un artículo anterior.

Image1 Intel Nehalem EX.

Con 2.3 BT (2.300.000.000 transistores) fabricados en el nodo de 45 nm cuenta con ocho núcleos basados en la arquitectura Nehalem (similar a los Core i7 de sobremesa) y cuatro enlaces QPI para comunicación con otros tres sockets y el chipset.

Image2 Diagrama del die.

Los tamaños de caché. La L3 de 24 MB

Una cuestión interesante es la inclusión de una L3 de 24 MB con acceso compartido por ocho núcleos. Teniendo en cuenta que las L2 son de solo 256 KB sus tasas de acierto no serán espectaculares y esto nos lleva a pensar que la L3 tendrá mucho trabajo.

Hace unos meses haciendo profiling comparativo en máquinas Core 2 y Athlon64 comprobé que los Core 2 fuerzan mucho más (en el sentido de acceder muchas más veces) su L2 de 6 MB que los AMD Athlon64. Esto es debido a que los Athlon64 cuentan con una L1 de 64 KB que mitiga mucho (dada su mayor tasa de aciertos) los accesos a L2, en cambio, los Core 2 con su pequeña L1 de 32 KB hacen un uso intensivo de su excelente (rapidísima para su tamaño) y gigantesca L2 de 6 MB.

Sin duda, con Beckton (Nehalem EX) el extenso equipo de ingeniería de Intel ha hecho un excelente trabajo en la identificación de los más favorables tamaños relativos de sus cachés y han llegado al diseño final de 24 MB de L3 (LLC) para 8 cores con 16 threads.

Caché de cuarto nivel, L4

Lo que sí es cierto es que espero, en generaciones posteriores y ya con un número de núcleos mayor, la aparición de masivas cachés L4 compartidas (de tamaños sobre los 48 - 64 MB) probablemente con buses ring-bus.

Para mitigar los accesos hacia ellas habrá cachés L3 compartidas parciales (entre unos 4 – 8 núcleos por L3) de menor tamaño (sobre 4 – 8 MB) y mejor latencia que las actuales L3 de Beckton.

Por supuesto, todo esto nos espera en los 22nm y más allá …

LGA 1156. Intel Core i3, Core i5 y Core i7 – LowLevelHardware

Intel ha desvelado sus planes finales para los sustitutos de sus exitosas líneas Core 2 Duo y Quad, todos ellos serán procesadores de socket LGA 1156 con dos canales de memoria DDR3 y con conexión con el nuevo chipset Intel P55 mediante un simple enlace DMI de 2 – 4 GB/s.

LGA1156 LGA 1156, el nuevo socket mainstream de Intel.

Todos ellos estarán basados en la arquitectura Nehalem ya conocida en los actuales Core i7 LGA 1366. En cuanto a la caché L3, los quad core contarán con 8 MB de L3 y los dual core con la mitad, 4 MB.

Tech_IntelTechnology@Intel

Core i7 LGA 1366 serie 900

La actual serie 900 que todos conocemos con triple canal DDR3 y bus QPI para comunicación con el Intel X58. Seguirá manteniendo el liderato en prestaciones y el mayor precio.

Core i7 LGA 1156 serie 800

i7 Los actuales procesadores Core i7 de socket LGA 1366 quedan como gama alta (serie 900) y se lanzarán varios modelos para placas de socket 1156 y chipset P55 (serie 800) con doble canal DDR3.

Contarán con cuatro núcleos con HyperThreading y Turbo Mode para un total de ocho threads como en la actual gama 900.

Core i5 LGA 1156 serie 600

i5 Habrá modelos de dos y cuatro núcleos, los de dos núcleos contaran con HyperThreading (SMT) y en cambio los quad cores lo llevarán deshabilitado para diferenciarlos de los Core i7. Todos ellos contarán con Turbo Mode.

También como chipset con el Intel P55 mediante DMI.

Core i3 LGA 1156 serie 500

i3 Serán idénticos a los i5 pero con Turbo Mode deshabilitado y seguramente frecuencias inferiores. Igualmente con el Intel P55.

Phenom II X2, Athlon II X2 y el futuro Athlon II X4. Nuevos cores de AMD – LowLevelHardware

Advanced Micro Devices está ejecutando su roadmap admirablemente, de una manera que pocos esperaban teniendo en cuenta el gran éxito y presión ejercida por su rival y mayor fabricante mundial, Intel Corp.

AthlonIIAthlon II X2: el dual core nativo de 45 nm, codename: Regor.

En las últimas semanas AMD ha presentado tres nuevos diseños:

  • Un hexacore nativo con L3 de 6 MB: AMD Istambul
  • Un dual core nativo con dos L2 de 1 MB: AMD Regor o Athlon II X2
  • Un quad core nativo con cuatro L2 de 512 MB y sin L3: Athlon II X4

En un artículo anterior esbozaba las nuevas estrategias de futuro y la visión más técnica y práctica del nuevo CEO de AMD, Dirk Meyer, todo un profesional del diseño de procesadores.

PhenomII_NO_L3 Athlon II X4: Quad core nativo sin caché L3 y con un solo bus HT bidireccional, codename Propus.

Hablando de un futuro próximo, en breve tendremos en el mercado los nuevos Athlon II X4, de los que os presento arriba fotografía del die y donde observamos que carece de caché L3 y solo cuenta con un link HT. Además las cachés L2 son de 512KB como en Shanghai.

Y en presente… AMD, ya de lleno en el nodo de 45 nm, nos presenta hoy su nueva gama de procesadores dual core para el segmento medio del mercado, compuesta por dos series.

AMD core Regor - Athlon II X2 serie 200

Con este procesador AMD quiere sustituir todos los procesadores basados en los antiguos núcleos Athlon64 X2 Brisbane de 65 nm todavía en el mercado migrando toda la gama X2 a 45 nm y núcleos de arquitectura K10.5.

Sus prestaciones son claramente superiores a los anteriores núcleos K8 y K10 (los primeros Phenom Barcelona de 65 nm) y cuentan con una arquitectura de procesamiento actualizada e idéntica a los Phenom II X4 de 45 nm basados en el núcleo Shanghai.

Analizando el díe observamos algunas características notables:

  • Es un diseño dual core nativo, compacto y muy optimizado en superficie.
  • Se ha reducido notablemente el tamaño del Uncore respecto a Shanghai al no necesitar toda la lógica de gestión de la caché L3.
  • Cuenta con dos L2 discretas e independientes aumentadas a 1 MB y con 16 vías de asociatividad como en los Phenom, Phenom II y en los antiguos Athlon64.
  • Hay dos controladoras de DDR2/DDR3, como en Shanghai (Phenom II).
  • No hay caché L3 para optimizar su tamaño.
  • El número de enlaces HyperTransport se reduce a uno a una frecuencia de 2 GHz.
  • La superficie estimada ronda los 117 mm2 para 234M de transistores, un resultado muy satisfactorio.
  • Las frecuencias iniciales rondan los 3 GHz.

AthlonII_croquis Esquema del procesador Athlon II.

Su disipación térmica se reduce a un TDP máximo de 65W, siendo (ahora sí) una excelente opción para sistemas destinados a reproducción BluRay o DVD de salón.

En pruebas reales ha dado sobre unos 30 – 35 W en carga máxima (consumo aislado del procesador) y en reposo memos de 10W. Realmente podemos decir que es un procesador fácil de refrigerar.

AMD core Callisto - Phenom II X2 serie 500

El procesador Phenom II X2 no es un dual core nativo y por ello su disipación térmica es más elevada que en el caso del nuevo Athlon II, aunque no por ello es excesiva. En medidas reales ronda los 50 W en carga 100 % de los dos núcleos.

Shanghai Die de Shanghai quadcore de 45 nm y 6 MB de caché L3.

El Phenom II X2, igual que el Phenom II X3, comparten die con el “completo” Phenom II X4 quadcore. De hecho todos ellos son el mismo procesador, lo que ocurre es que AMD desactiva respectivamente dos o uno de los núcleos.

Esta inactivación de cores puede responder a dos razones:

  • Alguno de los núcleos no es funcional.
  • Por razones económicas o de stock (exceso de quads o falta de X2s) necesita producir mayor número de CPUs dual core.

El lado positivo es que el AMD Phenom II X2 goza de una caché L3 completa de 6 MB para tan solo dos núcleos (3 MB de L3 por procesador) lo que aumenta sus prestaciones de media sobre un 5 a 8 % sobre el Athlon II X2 clock for clock. En pico llega a ser hasta un 18 % más rápido.

Por contra, al ser un chip de 751M de transistores, su consumo y disipación térmica no pueden ser tan contenidos como en el caso del Athlon II X2 y se acerca incluso a sus parientes quadcore con un TDP de 80W. Siendo para AMD el TDP la potencia máxima teórica consumida por el procesador en carga máxima y en condiciones críticas de temperatura y alimentación eléctrica.

El tesoro oculto en Phenom II X2

Al ser un quadcore nativo con dos núcleos deshabilitados es posible, en ocasiones, volver a activar estos dos procesadores. Para ello necesitamos una placa base que tenga en BIOS la opción del ACC (Advanced Clock Calibration).

Al activar esta opción nos podemos encontrar con dos situaciones:

  • Tenemos un flamante quadcore con 6 MB de L3 perfectamente funcional a precio de dual core.
  • Alguno de los núcleos activados es defectuoso y obtendremos errores, cuelgues o incluso fallos en el arranque.

Ciertamente no hay otro modo de averiguarlo que probar… Sin duda que ahora que salen al mercado hay más probabilidades de que sean quad cores funcionales y conforme avance el proceso de fabricación iremos encontrando más CPUs con núcleos defectuosos.