Mostrando entradas con la etiqueta Sandy Bridge. Mostrar todas las entradas

jueves, 2 de febrero de 2017

Intel Core i7 2600 K. Análisis cachés L0i 6 KB y L3 unificada 8 MB – LowLevelHardware

Con Sandy Bridge, Intel ha innovado en el diseño de cachés y como primicia nos ofrece una caché L0i (caché de instrucciones) que contiene instrucciones ya decodificadas procedentes de la caché L1 de 32 KB y 8 vías a través de los decoders x86.

La micro op cache o L0i de 1500 micro ops

DCache_RAM_Lat_rmma_20110209_055954_0734Data caches: observamos las cuatro zonas de caché y la RAM.

La caché de instrucciones de nivel 0 (L0i) de los procesadores Sandy Bridge es una caché de micro operaciones, es decir, de instrucciones ya descodificadas en un formato interno, propietario del procesador.

Para un análisis a fondo de la micro op cache os recomiendo el siguiente enlace:

Intel Sandy Bridge Core i7 2600 K. Análisis X86 decoders y L0i micro op cache – ProfessionalSAT

La caché L1i e igualmente los niveles superiores contienen las complicadas instrucciones X86 sin descodificar. Intel, que en su día diseño la ISA X86, sabe que es compleja y a veces absurda en su arquitectura y por ello ha tomado esta medida novedosa, la inclusión de un nuevo nivel de caché L0.

SB_uopcacheL0i en Sandy Bridge.

La tasa de aciertos se cifra en torno al 80% para un tamaño sobre los 6 KB y una transferencia pico de 32 bytes / ciclo.

En las prueba de bajo nivel que he realizado su tamaño efectivo ronda los 2 a 4 KB, con unas latencias prácticamente ridículas de 2 ciclos load to use en lectura secuencial o en acceso pseudo aleatorio.

rmma_20110209_064736_0281Instruction cache: la L0i obtiene una increíble latencia de 2 ciclos.

En acceso aleatorio puro (random access) su tasa de aciertos es cero (lógicamente las instrucciones no pueden estar decodificadas y cacheadas previamente a su petición ya que se trata de un patrón aleatorio) y se dan en su caso aciertos de L1i (L1i hits) con los habituales 4 ciclos de latencia.

Caché L3 unificada y multibanco de 8 MB y 16 vías

Sandy Bridge cuenta con una L3 con cuatro bancos de 2 MB y 16 vías. El acceso al banco local de cada core se hace directamente y con baja latencia. A los otros tres bancos  se llega a través del Ring Bus.

SB_4C_630p_coresSandy Bridge 32 nm. Bajo cada core está su banco local L3 de 2 MB.

L3_Lat_2048K_M2_rmma_20110211_135757_0687Acceso L3 con bloque de 2048 KB.

La latencia efectiva se sitúa en los 34 ciclos en acceso pseudo aleatorio y en 40 ciclos en modo random (aleatorio). Son resultados muy brillantes.

SandyBridge_dieEl core de Sandy Bridge junto con su banco local L3 de 2 MB.

Para tamaños de acceso mayores de 2 MB, el núcleo de ejecución se ve obligado a acceder a bancos de L2 de 2 MB no locales a través del Ring Bus. Por ello, lógicamente la latencia se incrementa.

L3_Lat_6144K_M2_rmma_20110211_140032_0843Acceso L3 con bloque de 6 MB (6144 KB).

En los Core i7 2600K contamos con la implementación completa de cuatro bancos L3 para un total de 8 MB, en otras versiones inferiores Intel deshabilita uno de los bancos quedando en 6 MB L3.

Conclusiones

Esperad en breve una ampliación de este artículo, tengo bastantes datos técnicos y microarquitecturales que agregar pero voy realmente mal de tiempo… En concreto estoy preparando un análisis más exhaustivo de la L0i o micro op cache incluyendo una investigación del ancho de banda de descodificación con distintos tipos de instrucciones.

Espero que con esta pequeña introducción tengáis material suficiente para pensar como se mejora un diseño ya excelente partiendo de un core Nehalem / Westmere.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Intel Series 6 chipsets stepping B3 – LowLevelHardware

Intel ha anunciado que a partir del 14 de Febrero estarán disponibles los primeros samples del renovado stepping B3 de los chipsets de la serie 6 afectados por el bug en las controladores SATA2.

Intel_P67_H67_B3_01Intel Product Change Notification 110456 – 00.

Verdaderamente es llamativo como en un periodo de tiempo tan reducido han logrado producir chips funcionales con el error de diseño corregido.

Para un análisis profundo del tema os recomiendo otros de mis artículos:

Intel Sandy Bridge- Análisis de situación – ProfessionalSAT

Cougar Point Intel 6 Series Chipset SATA2 bug. Actualizado – ProfessionalSAT

Intel_P67_H67_B3_02El nuevo B3 es pin compatible con los anteriores diseños.

En principio los fabricantes de placas base empezarán a recibir los primeros chips el día 14, es decir, mañana mismo. Desde ese momento comenzará la fabricación de las nuevas placas.

Incluso se especula en que en algunos diseños sería posible desoldar el chip B2 defectuoso sustituyéndolo por el nuevo B3 sin cambiar la placa ni otros cambios.

Intel_P67_H67_B3_03Lista de chipsets afectados.

Conclusiones:

Quizás haya suerte y en breve tengamos placas funcionales y libres de errores para poder montar los primeros sistemas Sandy Bridge de sobremesa con garantías.

En cualquier caso, en mi opinión, Intel debe hacer algo más para recuperar la confianza, en muchos casos perdida y en otros debilitada, del consumidor final. La gente de Intel lo sabe y espero que obren en consecuencia con medidas claras.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Microarquitectura Intel Sandy Bridge. Parte 1. Actualizado - LowLevelHardware

Estos días Intel está celebrando en San francisco el IDF 2010 (Intel Developer Forum), entre multitud de temas relacionados con el futuro de la industria de semiconductores ha hablado de Sandy Bridge.

SandyB_Nehalem_WestmereSandy Bridge tiene menor superficie de die que Nehalem pese a contar con una GPU con 12 SPs.

En estos artículos me voy a centrar en los cambios microarquitecturales de Sandy Bridge sobre la anterior generación de cores de Intel, Nehalem 45 nm y Westmere 32 nm.

En esta primera parte abordaré varios aspectos:

  • Intel Tock 2010. La aplastante cadencia del gigante de los semiconductores.
  • Sandy Bridge Ring Bus. La nueva organización de la comunicación inter die.
  • El System Agent de Sandy Bridge. El Uncore o North Bridge.
  • El Front End de Sandy Bridge. Las primeras etapas del pipeline.
  • El mecanismo de Branch Prediction, tan críticamente importante en algoritmos de enteros.

Intel Tock 2010

Sandy Bridge es un cambio profundo respecto a la ya excelente y exitosa microarquitectura que Intel puso en juego en 2008 con Nehalem, los cores que mueven los chips Core i7.

SB_TOCK_630 Sandy Bridge es el Tock de 32 nm tras Nehalem y Westmere.

Poco había que mejorar en la arquitectura de los cores Nehalem, ya que Intel lidera en prestaciones en todos los campos… pero los grupos de ingeniería en Intel no podían quedarse dormidos en los laureles (como desafortunadamente hizo AMD tras su excelente core K8).

PIN_630 La próxima generación: Intel Sandy Bridge.

Por ello han procedido a un exhaustivo y profundo rediseño:

Desde el Front End, hasta las unidades de ejecución, el Branch Prediction e incluso las unidades Load – Store. También se ha modificado la arquitectura de la cache L3 dividiéndola en bancos de 2 MB por core y la interconexión interna de las diferentes partes del procesador.
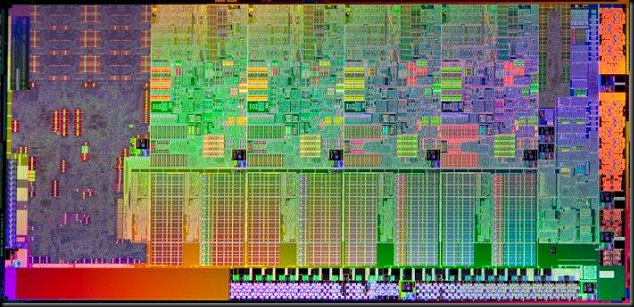
SandyBridge_Die_2_630 (2) Die de Sandy Bridge quad core 32 nm.

El Ring Bus que ahora hace de ruta de comunicación entre todas y cada una de las partes del procesador:

  • cores
  • Bancos de L3 de 2 MB
  • System Agent -Uncore o North Bridge-
  • GPU integrada
  • Video decoder – encoder

Es, a mi modo de ver, uno de los cambios más significativos respecto a diseños anteriores (Westmere y Nehalem).

SB Intel no ha dejado nada al azar con Sandy Bridge.

Sandy Bridge Ring Bus

Intel ha dotado a Sandy Bridge de un novedoso y extremadamente rápido sistema heredado de su hermano mayor Nehalem EX, un anchísimo y eficiente Ring Bus de comunicaciones para coordinar todas las transacciones de datos inter die.
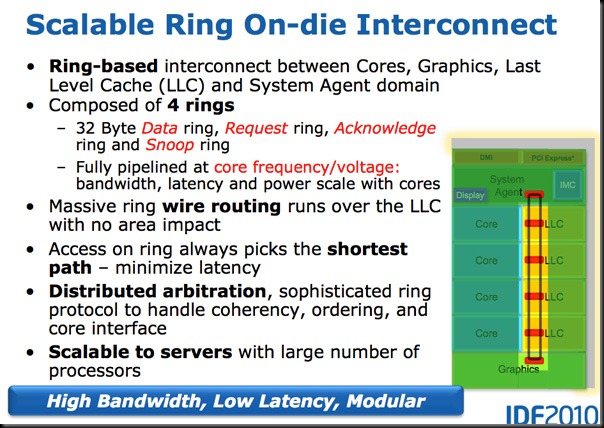
SB_RING Implementación del Ring Bus en Sandy Bridge.

El ancho de banda del bus de datos es de 32 bytes, es decir, 256 bits y su topología es en anillo, es decir, escala con el número de cores y bancos de L3. A mayor número de cores o bancos de L3 mayor ancho de banda agregado.

Lo más llamativo del bus en anillo de Sandy Bridge (y Nehalem EX) es su implementación respetuosa con el consumo y el área de die, me explico:

Todos recordamos el famoso procesador Radeon HD 2900 de ATI con un ring bus de 512 bits, que debido a su desmesurada disipación térmica y consumo no pudo competir con sus análogos de nVidia hasta que ATI lo eliminó sustituyéndolo por una arquitectura convencional en su serie Radeon HD 3800.

En Sandy Bridge Intel ha utilizado power gating y clock gating extensivamente, además de aplicar un voltaje bajísimo al ring bus para conseguir una disipación térmica muy baja.

Por otro lado, es un dato muy importante, según los ingenieros de Intel, no ha representado un incremento de área ya que la infinidad de conductores necesarios para el Ring Bus se enrutan por otras capas del diseño bajo la caché L3.
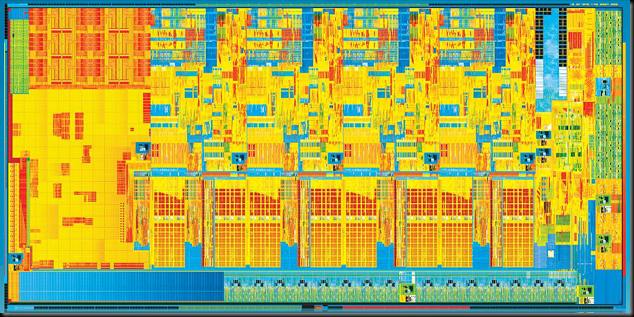
SB_Die_630 Sandy Bridge quad core para socket LGA 1155.

Lo que se consigue con este ring bus es aumentar de manera lineal el ancho de banda agregado (total) con el número de Ring Stops (cores, bancos de L3, …) consiguiendo una escalabilidad perfecta.

Como he comentado en artículos anteriores, además se consigue una muy notable bajada de latencia de la caché L3, del orden del 30% (!!) que ya de por sí en Nehalem y Westmere era realmente rápida.

Ahora nos encontramos en los veintitantos ciclos de latencia respecto a los 38 - 42 ciclos de Nehalem y algo más en Westmere.

El System Agent de Sandy Bridge

El anteriormente denominado Uncore, Nocore o North Bridge ahora no incluye ya la caché L3, por lo que la L3 es síncrona a los cores, con lo que aumenta su frecuencia aumentando su ancho de banda y disminuye su latencia.

SB_SASandy Bridge System Agent.

El System Agent se encarga de controlar todas las transacciones entre los cores, la GPU integrada, los coders y decoders de video integrados con:

  • La memoria principal a través de las dos controladoras DDR3.
  • Las GPUs externas a través de los puertos PCI Ex.
  • Los dispositivos externos a través del DMI vía chipset.

Para mejorar la disipación térmica y reducir el consumo en sistemas portátiles integra la controladora de video y la PCU (Power Control Unit) encargada de gestionar los voltajes y las frecuencias de los cores así como los Turbo Modes y los modos de ahorro de energía y el Power Gating a nivel de cores.

El Front End de Sandy Bridge

El Front End es la parte del microprocesador encargada de suministrar la secuencia de instrucciones X86 desde la caché L1i (cache L1 de instrucciones) y de descodificarlas a un formato más manejable (micro operaciones, uops).

Intel, en este apartado ha roto con el pasado y ha desarrollado un Front End revolucionario.

Estas instrucciones ya descodificadas se encuentran en un formato interno y propietario, son llamadas uops (micro operaciones) y son características de cada microarquitectura.
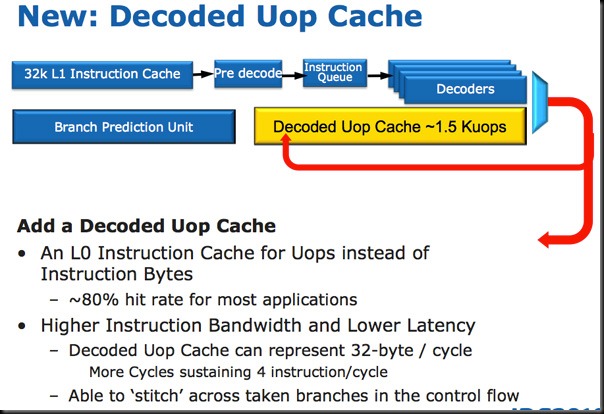
SB_uopcache uop cache en Sandy Bridge, una especie de L0i.

Sandy Bridge mejora el Loop Stream Buffer de Westmere 32 nm que contenía hasta 28 uops con una estructura dedicada llamada Decoded uop Cache que es capaz de almacenar unas 1500 uops (sobre unos 6 KB de capacidad) y que actúa a modo de caché L0 de instrucciones suministrando a las etapas de ejecución fuera de orden instrucciones con menor latencia que la L1i de 32 KB y además manteniendo más fácilmente la cadencia de 4 uops / ciclo.

Además el Fetching desde esta nueva L0i se hace en paquetes de 32 bytes / ciclo, aumentando el llenado efectivo de las unidades de ejecución que le siguen en el pipeline.

Intel cita la tasa de aciertos de esta L0i en un 80% en código de aplicaciones típicas. En el caso de acierto (que como vemos es un 80% de las veces) se desconectan las etapas de Fetch y Decoding con el consiguiente ahorro energético y de temperatura (muy notable ya que el consumo de estas etapas es muy alto en CPUs de arquitectura X86).

Entre los mecanismos que forman parte integral del Front End nos encontramos con la lógica y SRAMs de Branch Prediction encargado de cargar en el orden correcto la secuencia de instrucciones después de una bifurcación en el código (Branch) decidiendo si la condición se cumple o no mediante lógica y algoritmos de especulación y distintas tablas de datos de historia precedentes.

El mecanismo de Branch Prediction

Sandy Bridge ha mejorado notablemente el manejo de Branches en el código, aumentando la tasa de acierto. Los ingenieros de Intel han optimizado el diseño pero permaneciendo en el misma footprint (la misma superficie).

SB_Branch Optimización del Branch Prediction en Sandy Bridge.

Utilizando técnicas de compresión sin pérdidas en Sandy Bridge se almacenan más datos de historia en la misma capacidad que en Westmere por lo que efectivamente se han ampliado al doble el número de entradas en las tablas de Targets, elevando con ello la tasa de aciertos de los algoritmos respecto a Westmere.

Estoy deseando probar Sandy Bridge en algoritmos ajedrecísticos.

Nos vemos en la segunda entrega.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

Previo Intel Sandy Bridge. Actualizado – LowLevelHardware

Debo reconocer que siento admiración y hasta cierto punto incluso perplejidad sobre cómo han logrado los ingenieros de Intel mejorar tanto una arquitectura ya sobresaliente como Nehalem…

Ya en algunos artículos pasados he hablado de Sandy Bridge:

Intel Tick - Tock

Todos conocemos el modelo de trabajo Tick - Tock de Intel, cada dos años nueva microarquitectura y en los años intermedios nuevo proceso de fabricación:

Intel Tick-TockEl exitoso e implacable modelo Tick – Tock de Intel.

  • 2005 Presler 65 nm (Intel Pentium D, 2 cores, 2 + 2 MB L2)   Tick
  • 2006 Conroe 65 nm       (Core 2 Duo, 4 cores, 4 + 4 MB L2)   Tock
  • 2007 Penryn 45 nm       (Core 2 Duo, 4 cores, 6 + 6 MB L2)    Tick
  • 2008 Nehalem 45 nm        (Core i7, 4 cores SMT, 8 MB L3)    Tock
  • 2009 Westmere 32nm     (Core i7, 6 cores SMT, 12 MB L3)    Tick
  • 2010 Sandy Bridge 32 nm       (Core i7 SMT, 6+ cores SMT)    Tock
  • 2011 Ivy Bridge 22 nm           (Core i7 SMT, 8+ cores SMT)    Tick

El Tick significa nuevo proceso de fabricación, más fino, transistores menores y mayor densidad por unidad de superficie. Cachés mayores, menor consumo,menor disipación térmica y mayor frecuencia.

El Tock por el contrario consiste en una nueva microarquitectura para aprovechar todas las ventajas aportadas por el nuevo proceso de fabricación del año anterior.

Sandy Bridge esta fabricado en el mismo nodo que los recientes procesadores Westmere de 6 cores y 12 MB de L3 para socket 1366 o los Core i3 e i5 con GPU integrada para socket 1156. Comparte con ellos la tecnología de fabricación de 32 nm HKMG.

Intel Sandy Bridge, pequeña introducción

Lo que cambia en Sandy Bridge y cambia de verdad es la microarquitectura; reconozco que inicialmente y viendo la poca competencia con que Intel se enfrenta en gama alta pensé que Sandy Bridge sería una mejora más sutil sobre los excelentes cores Nehalem que nos acompañan desde 2008.

SB_4C_630p_coresIntel Sandy Bridge socket 1155. Quad core con GPU integrada, 8 threads y dual DDR3.

Continuará con la capacidad SMT de dos threads por core (HyperThreading) y numerosas mejoras a nivel de cores, caches, interconexiones inter core, disipación térmica y GPU integrada.

Core El núcleo de ejecución incluyendo las L1d y L1i y la caché L2 de 256 KB.

A nivel de cores espero un incremento en IPC por core de un 20% (!!) en enteros y un 100% en código AVX 256 bit FPU respecto al antiguo código SSE de 128 bit respecto a Westmere. Es algo prácticamente increíble sabiendo con qué lo comparamos pero es así… tiempo al tiempo.

Una mejora crítica en Sandy Bridge es su subsistema de caché L3. Está basado en una arquitectura RING BUS. Esta arquitectura es conocida por el revolucionario procesador octal core Nehalem EX, que con su doble RING BUS bidireccional logra superlativos resultados en ancho de banda y latencia de su masiva L3 de 24 MB en 8 bancos de 3 MB.

En Sandy Bridge conllevará reducciones de latencia L3 del orden de 15 ciclos para la L3 compartida de 8 MB, quedando en unos 25 – 28 ciclos efectivos load to use… simplemente brutal.

L3 Los cuatro bancos de L3.

En el terreno del consumo eléctrico, Sandy Bridge consigue mejorar a Lynnfield (p.ej. Core i7 880), el mejor procesador en performance per watt con diferencia.

Sobre la GPU integrada, Sandy Bridge llegará en sus versiones básicas al nivel de SVGAs PCIEx de gama baja como las ATI 5450. Las versiones alta de SB se moverán ya en niveles de prestaciones gráficas realmente aceptables, sobre una ATI 4650 con 320 SPs o algo superior.

GPU Detalle de la GPU y la circuitería colateral.

Los sockets de Sandy Bridge

Intel ha diseñado dos nuevos e incompatibles socket para Sandy Bridge:

  • Socket 1155. Sustituto del actual LGA1156, contará con 2 canales DDR3.
  • Socket 2011. Sustituto del actual LGA1366 contará con cuatro (!!) canales de DDR3 hasta 2133 MHz. Serán excelentes para mis Sistemas de Altas Prestaciones.

Meditad sobre el 20 % de mejora en IPC clock for clock y core for core respecto a Westmere… a mí me cuesta asumirlo. Estoy deseando echarle el guante a los primeros ejemplares para socket 2011, será en Q2 - Q3 2011.

Más por llegar…

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

domingo, 25 de diciembre de 2011

¡Felices fiestas desde LowLevelHardware! – LowLevelHardware

¡Felices fiestas a todos desde LowLevelHardware!

Como es obligada tradición estos días estoy con la familia celebrando las fiestas pero desde el día 27 empiezo a sustituir 12 de mis Sistemas de Altas Prestaciones basados en CPUs Sandy Bridge Core i7 2600K @ 4.4 GHz por antiguos, venerables y probados Nehalem Core i7 930 y 950 @ 4 GHz.

SB_4C_630p_cores_thumb[1]

¿Extraño? Simplemente los Sandy Bridge son un 30% más lentos que los Nehalem en los cálculos matemáticos intensivos que emplea uno de mis mejores clientes… he descubierto un “defecto” en la excelentísima nueva  arquitectura de Intel.

Tras semanas de testing he descubierto la causa, recordáis la caché de micro operaciones de 1500 uOps nueva en SB, pues en estos algoritmos crea un GRAVE problema prestacional.

Lo denomino “micro code cache inter thread thrashing”. Un thread expulsa de la uOp cache los datos del otro thread constantemente y hace que la velocidad de cálculo sostenida del procesador baje alarmantemente.

SB_uopcache_thumb[1]

Un Core i7 Nehalem @ 4 GHz realiza 1000 iteraciones del cálculo con ocho threads simultáneos en 3100 s, un SB @ 4.4 GHz tarda unos absurdos 4050 s.

Es un resultado absolutamente repetible con una variación de máquina a máquina máxima de 50 s y lo he probado con 12 CPUs distintas SB y 24 Nehalem y con placas base SB P67 y Z68. Única opción: volver a los antiguos i7…

die_thumb[1]El venerable y efectivo Nehalem de 45 nm.

Disfrutemos de estos días antes de ponernos manos a la obra… lo dicho, ¡Felices Fiestas!

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.