Mostrando entradas con la etiqueta Bulldozer. Mostrar todas las entradas

jueves, 2 de febrero de 2017

AMD Excavator 28 nm – LowLevelHardware

Ya a finales de 2015, AMD nos trae la cuarta y última iteración de su arquitectura Bulldozer inicialmente lanzada en el nodo 32 nm HKMG de Global Foundries.

Carrizo coresDos módulos AMD Excavator (cada uno con 2 INT cores) con 2 cachés L2 de 1MB.

Tras eliminar numerosos bugs, activar unidades deshabilitadas en Bulldozer (generación 1) como la IDIV y reducir paulatinamente el consumo con Piledriver 32 nm (generación 2) y Steamroller 28 nm (generación 3) además de ir lentamente aumentando el IPC, llega Excavator 28 nm con mejoras incrementales en muchos aspectos y también alguna pequeña revolución.

Excavator. los cambios más importantes respecto a las generaciones anteriores:

  • Reducción de la caché L2 de 2 MB a 1 MB por módulo con una importante reducción de área y mejorando la latencia. 2 MB L2 era demasiado para este tipo de cores fabricados en 28 nm, un mal compromiso área / prestaciones.

CarrizoL1d_32KB_8víasAMD Excavator L1d: 32 KB 8 vías.

  • Por fin se dobla el tamaño de la caché L1d de 16 KB a 32 KB por INT core y su asociatividad aumenta hasta las 8 vías. Por fin AMD ha visto la luz en cuanto al diseño de la caché L1… 32 KB con 8 vías es un excelente diseño. Era una mejora muy necesaria.
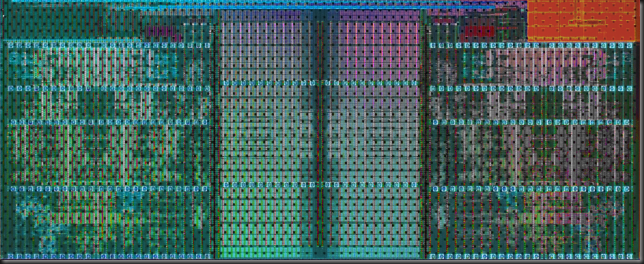
Kaveri 2 Clusters 2xL2Dos módulos AMD Steamroller (cada uno con 2 INT cores) con 2 cachés L2 de 2 MB.

Desgraciadamente, AMD no puede fabricar actualmente en nodos de 20 / 22 nm ni en los nuevos nodos de 14 nm (como su rival Intel) con el fin de reducir el área de sus productos y con ello su coste de fabricación.

Solución de los ingenieros de AMD: seguir en los 28 nm pero reduciendo el área (superficie) de sus chips implementando librerías de alta densidad procedentes del mundo del diseño de GPUs:

LibreríaAltaDensidad640Con el uso de librerías de alta densidad AMD logra reducir el área de Excavator.

Gracias a estas mejoras se cifra en un 30% la reducción de superficie.

A todas estas nuevas técnicas se añaden las mejoras importantes que Steamroller 28 nm ya introdujo respecto a sus antecesores de 32 nm, Piledriver y Bulldozer:

  • La L1i compartida para los 2 INT cores aumentó a los 96 KB y una asociatividad de 3 vías (representó un gran avance sobre los 64 KB / 2 vías, aunque 3 vías sigue siendo poco, muy poco para dos threads).
  • El decoding doble por módulo, uno para cada INT core, un cambio que esta microarquitectura (Bulldozer) pedía a gritos…

Excavator y el segmento de 15 watt:

Hay que tener claro que AMD busca reducir el consumo y disipación térmica de sus SOCs por todos los medios posibles y por ello ha optimizado críticamente Excavator y su primera implementación comercial, las APU Carrizo con 4 INT cores y 8 clústeres GCN 2 (Radeon R7).

Por ello ha optimizado el conjunto de 4 INT cores + 8 clústeres GCN 2 + controladoras DDR3 y resto de circuitería para un TDP de 15 watt, que se extenderá fácilmente a los 35 watt.

Carrizo15_640AMD Excavator: excepcional rendimiento en 15 watt. Con 35 watt menor ventaja.

Esto significa que cuanto mayor frecuencia le pidamos a Excavator, menor ventaja mostrará respecto a sus antecesores. No esperéis diseños de Carrizo de 100 watt a frecuencias de 4 GHz o más.

Las frecuencias iniciales rondarán a 35 watt los 2.1 GHz con Turbo hasta 3.4 GHz con los cores gráficos a 800 MHz y soporte de DDR3 2133 en el modelo tope de gama, el FX-8800P.

Frecuencias640

No está nada mal para 35 watt, un excelente resultado.

Conclusiones

AMD prepara el desembargo de Zen 14 nm, seguro que no sin numerosos problemas. Recordemos que va a utilizar el nodo de 14 nm de Samsung (ya fabrica los SOCs de los Galaxy S6 con esta tecnología) y no estará exento de dificultades el diseñar un chip tan complejo como Zen en un nodo y proceso de fabricación tan sumamente diferente de los actuales.

El puente hacia Zen son los chips con cores Excavator y AMD ha demostrado que ve claras las necesidades del mercado con su enfoque en el segmento de los 15 watt.

Excavator parece que dará mucha guerra en el segmento de los UltraBooks, será un chip muy equilibrado en TDPs de 15 a 35 watt, en este sentido, incluso creo que puede ser un gran rival respecto a los Core i5 de la serie U.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes. Gracias de antemano.

El que tenga dudas o aportaciones tiene para ello la sección de comentarios, intentaré responder a todos y con la máxima claridad. Los Blogs deben de ser lugares de intercambio y agradezco vuestro feedback.

AMD Steamroller core. AMD Kaveri. Parte 2 – LowLevelHardware

La primera implementación comercial de los cores Steamroller 28 nm es en las nuevas APU Kaveri, formadas por 2 clústers de 2 INT cores y una FPU y dos cachés L2 de 2 MB junto con la GPU integrada basada en la última generación de gráficas Radeon GCN 2.0.

Kaveri28nmDie de AMD Kaveri 28nm. En naranja la GPU Radeon R7.

El proceso de fabricación de 28 nm SHP de Global Foundries

AMD ha dado un paso decidido que marca una nueva etapa para la compañía: deja los procesos de fabricación orientados solamente a altísimas frecuencias (superiores a los 4 GHz) y opta por el contrario por procesos Bulk dirigidos a menor consumo, menor área con una penalización en frecuencia máxima.

Es decir, un procesador fabricado en el nuevo nodo de 28 nm SHP presenta mayor densidad de transistores por mm2, menor coste de fabricación, menor consumo a una frecuencia dada (por ejemplo en el rango hasta los 4 GHz aprox.) a costa de frecuencias pico inferiores.

A mi modo de ver una sabia y completamente acertada decisión, ya que, anteriormente, AMD no podía desplegar el potencial verdadero de frecuencia de la microarquitectura Bulldozer debido a su excesivo consumo al ir subiendo la frecuencia de funcionamiento con el necesario aumento exponencial de voltaje.

Es de esperar por ello, que desde ahora AMD se dedique a integrar más funcionalidades en cada uno de sus chips (más cores, más potencia de GPU…) ya que tiene un nuevo margen de disipación térmica máxima o TDP.

El core Steamroller

EN la tercera iteración de la familia de cores 15h, microarquitectura Bulldozer para los amigos, AMD ha hecho cambios realmente importantes respecto a la primera y segunda generación.

Steamroller Compute UnitUn cluster de arquitectura Steamroller: 2 INT cores, 1 FPU y 2 MB de L2.

Steamroller Cluster 640Fotografía de un clúster Steamroller perteneciente a un die AMD Kaveri 28nm.

EN AMD Kaveri se integran dos Clústers completos para un total de 4 INT cores:

Kaveri 2 Clusters 2xL2AMD Kaveri: Dos clústers Steamroller 28nm con sus cachés L2 enfrentadas.

En el siguiente artículo me centraré en las mejoras, muy extensas, introducidas por AMD en Steamroller.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes. Gracias de antemano.

El que tenga dudas o aportaciones tiene para ello la sección de comentarios, intentaré responder a todos y con la máxima claridad. Los Blogs deben de ser lugares de intercambio y agradezco vuestro feedback.

AMD Steamroller. Introducción. – LowLevelHardware

El 14 de Enero AMD sacó al mercado su tercera iteración de la micro arquitectura Bulldozer en la forma de la APU Kaveri fabricada por Global Foundries es el nodo Bulk SHP (Super High Performance) de 28 nm. En este caso se trata de una implementación de dos módulos con dos INT cores y una FPU compartida junto con una excelente GPU GCN 1.1 de 512 SPs.

excavator

La micro arquitectura AMD Bulldozer

Primero fue Bulldozer 32 nm HKMG, después Piledriver 32 nm HKMG y ahora Steamroller 28 nm Bulk SHP. Posteriormente, 2015, está previsto Excavator, la evolución final y que pondrá término a esta micro arquitectura. Después preveo que AMD, por fin, se centrará en diseñar cores de alto IPC y menor consumo para competir con mayor igualdad con los cores contemporáneos de Intel.

Como muchas veces ha sucedido con los diseños de AMD, en su primera versión.

En este caso Bulldozer 32 nm HKMG (AMD FX 8150) las prestaciones, consumo y disipación térmica no fueron las esperadas.

Piledriver 32 nm HKMG (AMD FX 8350) alivió ligeramente los problemas de consumo y mejoró las prestaciones.

Con Steamroller AMD plantea un cambio mucho más profundo:

  • Una evolución de la micro arquitectura mayor que en el caso de Bulldozer a Piledriver, con claras mejoras en algunos campos y otros cambios no tan claros en otros aspectos.
  • Un nuevo nodo de fabricación: del ya antiguo nodo premium HKMG 32 nm de Global Foundries utilizado en Bulldozer y Piledriver se pasa al nodo de 28 nm Bulk SHP, más orientado a menor consumo y mayor densidad (más transistores por mm2), es decir menor coste por chip y menor TDP, es decir, mayor performance per watt.

module-block

En la segunda parte de esta serie de artículos detallaré las mejoras implementadas en Steamroller por AMD y lo que significan de cara a sus encarnaciones presentes:

La APU Kaveri y los futuros chips FX Steamroller de alto rendimiento del que parece que están preparando una versión con 8 módulos y 16 INT cores con controladoras PCIex 3.0 integradas en el die del chip (lo que permitiría deshacerse del  North Bridge del chipset) que probablemente funcionará a frecuencias conservadoras en carga full threaded aunque con agresivos modos Turbo.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes. Gracias de antemano.

El que tenga dudas o aportaciones tiene para ello la sección de comentarios, intentaré responder a todos y con la máxima claridad. Los Blogs deben de ser lugares de intercambio y agradezco vuestro feedback.

AMD Bulldozer. Frecuencias finales. Actualizado – LowLevelHardware

Actualización 07 Septiembre 2011: Últimas noticias referentes al lanzamiento de Bulldozer y algunos datos técnicos extra al final del artículo.

InterlagosMCMUno de los primeros MCM Interlagos compuesto de 2 dies Bulldozer de 8 INT cores.

En la web de Gigabyte hemos encontrado las especificaciones finales de los procesadores basado en núcleos Bulldozer que próximamente saldrán a la venta.

Bulldozer_FXAMD Bulldozer. Por fin datos reales sobre los steppings comerciales.

Concretamente, la página en cuestión es la siguiente, correspondiente al soporte de CPUs de la placa base de socket AM3+ GA 990 FXA UD7.

En ella obtenemos alguna información extra sobre las nuevas CPUs de 32 nm de la serie FX.

Entre otros datos encontramos un TDP máximo de 125 W y la denominación B2 para el primer stepping comercial.

Bus Hyper Transport de 5.2 GHz

Todos los modelos ajustan su reloj HT3 a  GT/s. Sinceramente no veo razón para ello dado el excesivo ancho de banda ya disponible a las frecuencias de Thuban (Phenom II X6), GHz.

Obviamente la razón de esta alta frecuencia de 5.2 GT/s es comercial, marketing puro.

Este bus, en los procesadores de sobremesa, se utiliza para comunicar con el chipset y con los componentes periféricos. No es necesario un ancho de banda tan alto.

La especificación HT3 hace mención de frecuencias máximas hasta los 6.4 GHz (igual que el QPI de Intel), AMD ha sido prudente y ha dejado un margen para mejoras futuras.

Frecuencias base de AMD Bulldozer

La versión de 8 cores y 4 módulos (serie FX-8000) llegará hasta los 3.6 GHz nominales, desde ahí desplegará los modos Turbo.

Como comenté en el artículo anterior, AMD ha dotado a Bulldozer de un Turbo de dos fases:

640_5

Fase 1, All Core Boost: Todos los módulos (conjuntos de dos cores con su SIMD FPU Unit y los 2 MB de L2) aumentan su frecuencia por encima de la nominal si el TDP y la temperatura lo permite.

Se da en cargas de trabajo que implique a TODOS los cores, sea con carga parcial elevada o máxima 100%.

Fase 2, Max Turbo Boost: Si dos de los módulos (cuatro INT cores, dos SIMD FPUs y dos L2 de 2 MB) se hallan en estado Sleep C6 (power gated) el resto (los otros dos módulos) pueden incrementar su frecuencia hasta en 1 GHz sobre la nominal.

Esta implementación conlleva algunas consideraciones prestacionales extrañas y fastidiosas que detallaré cuando tenga hardware funcional comercial en las manos.

Se rumorean modos Turbo de hasta 1 GHz extra, es decir, hasta 4.6 GHz en carga 100% de 2 módulos, con los otros dos módulos en estado gated CC6.

En este caso tendríamos la siguiente capacidad de proceso:

  • 4 INT cores a 4.6 GHz en carga de enteros (compresión de datos por ejemplo).
  • 2 FPUs AVX de 256 bit en cargas de coma flotante AVX a 4.6 GHz.
  • 2 FPUs dobles de 128 bit en cargas de coma flotante SSE o AVX de 128 bit a 4.6 GHz.

Más información en breve.

Actualización 07 Septiembre 2011:

En primer lugar: Frecuencia máxima en modo Turbo Core: el modelo tope de gama FX-8150 (se enpecual con un FX-8170 para Q1 2012) será de 4.2 GHz con carga parcial de cores, probablemente con un máximo de 4 cores al 100%. Lo que no está nada mal manteniendo un TDP de 125W.

En segundo lugar: Nuevo evento de AMD en San Francisco para el día 13 de Septiembre:

Hanging out in San Francisco the week of September 12th? Not finding anything interesting?
AMD to the rescue. We'll be making an historic announcement, and want you to be a part of it.

AMD invites you to join us for an entertaining evening on the beautiful Yerba Buena Terrace at the St. Regis San Francisco. Spend the evening exploring the latest AMD technology, mingling with AMD executives and technology partners, all while enjoying cocktails and hors d'oeuvres. Be sure to arrive before 7:00pm to hear our big news first hand.

  When: Tuesday, September 13, 2011 RSVP
  Where: St. Regis Hotel, Yerba Buena Terrace, San Francisco
  Time: 6pm - 9 pm PDT
  RVSP: by September 9, 2011 at fusionzone.eventbrite.com (password: AMD)
Contact Information:
Heather J Lennon
Sr. Manager Public Relations, AMD
Heather.Lennon@amd.com
 

13 de Septiembre ¿Será el día de lanzamiento de Bulldozer?

Por último: Hoy AMD ha confirmado el comienzo de la venta de CPUs Interlagos de 16 cores para servidores a los integradores de sistemas. El primer chip con micro arquitectura Bulldozer.

"This is a monumental moment for the industry as this first 'Bulldozer' core represents the beginning of unprecedented performance scaling for x86 CPUs," said Rick Bergman, senior vice president and general manager, AMD Products Group. "The flexible new 'Bulldozer' architecture will give Web and datacenter customers the scalability they need to handle emerging cloud and virtualization workloads."

Para más información acerca de Bulldozer:

En múltiples artículos he analizado en detalle el diseño interno de BD 32 nm. Cito los más destacables:

AMD Bulldozer- HotChips23 – LowLevelHardware

AMD Bulldozer. Perspectivas – LowLevelHardware

La L3 cache multibanco en AMD Bulldozer. Actualizado – LowLevelHardware

AMD AGLUs, Bulldozer INT cores. Actualizado – LowLevelHardware

AMD Bulldozer. Primeros benchmarks. Actualizado – LowLevelHardware

AMD Bulldozer – ProfessionalSAT

La micro arquitectura de AMD Bulldozer. Actualizado – LowLevelHardware

Novedades y expectativas 2010. Actualizado – LowLevelHardware

AMD Bulldozer. Prestaciones estimadas – LowLevelHardware

Micro arquitectura AMD Bulldozer 2011. Actualizado – LowLevelHardware

Previo AMD Bulldozer. Actualizado – LowLevelHardware

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

AMD Bulldozer: HotChips23 – LowLevelHardware

Estos días se está celebrando el HotChips 23, una de las convenciones anuales donde se discuten los nuevos diseños de procesadores de sobremesa, servidores, memorias, procesadores de bajo consumo para dispositivos móviles… todo lo relacionado con el mundo del silicio en 2011.

Y claro está, también ha habido alguna nueva información sobre Bulldozer y mucha viejas ideas “refritas” sobre este nuevo core. Lamentablemente, ninguna estimación prestacional, puro silicon para entendidos en la materia.

AMD ha entrado en detalle en algunos aspectos del diseño del chip Zambezi (4 módulos y 8 INT cores) fabricado por Global Foundries en 32 nm SOI HKMG.

Nuevas fotografías del die de Bulldozer

En este slide de la presentación en HotChips vemos una nueva toma del die de Bulldozer.

640_1

Aparece con mayor altura que en anteriores vistas, si comparáis con anteriores artículos míos veréis claramente la diferencia. No hay modo de saber cual es la correcta, si esta o las antiguas (más alargadas), hasta que haya samples comerciales.

Ampliación del die:

640_2

Lo que me llama poderosamente la atención es la grandísima cantidad de espacio desaprovechado: No utilizado ni por cores (lógica) ni cachés ni por las controladoras de memoria y buses Hyper Transport 3.

En varios de mis numerosos artículos sobre Intel Sandy Bridge, mencioné el enrutado de todo el cableado del Ring Bus bajo la caché L3. Todo este esfuerzo de ingeniería se realizó para ahorrar espacio de die y reducir el tamaño de Sandy Bridge. Cito textualmente (Extraído de Microarquitectura Intel Sandy Bridge. Parte 1. Actualizado – LowLevelHardware. Martes 14 de septiembre de 2010):

“ Lo más llamativo del bus en anillo de Sandy Bridge (y Nehalem EX) es su implementación respetuosa con el consumo y el área de die, me explico:

Todos recordamos el famoso procesador Radeon HD 2900 de ATI con un ring bus de 512 bits, que debido a su desmesurada disipación térmica y consumo no pudo competir con sus análogos de nVidia hasta que ATI lo eliminó sustituyéndolo por una arquitectura convencional en su serie Radeon HD 3800.

En Sandy Bridge Intel ha utilizado power gating y clock gating extensivamente, además de aplicar un voltaje bajísimo al ring bus para conseguir una disipación térmica muy baja.

Por otro lado, es un dato muy importante, según los ingenieros de Intel, no ha representado un incremento de área ya que la infinidad de conductores necesarios para el Ring Bus se enrutan por otras capas del diseño bajo la caché L3. “

AMD simplemente no dispone de los extensos recursos económicos y humanos de Intel y no puede permitirse el lujo de este tipo de optimizaciones, bastante tiene con llevar a cabo el diseño de un semiconductor de tal complejidad como Bulldozer.

El espacio “muerto” lo he coloreado en GRIS, son muchos, muchos mm2:

640_2B

Superficie del die de AMD Bulldozer

Por fin conocemos el verdadero tamaño de Bulldozer y debo decir que estoy algo decepcionado: nada menos que 315 mm2… muy caro de producir.

Bulldozer_Die_size

Estoy convencido de que AMD sin duda optimizará este diseño en sucesivas iteraciones (con el paso a 22 nm en un par de años) e incluso antes con el lanzamiento de la versión de 5 módulos y 20 cores producida también en 32 nm.

Infraestructura de AMD Zambezi. AM3+

640_3

Como vemos la versión de sobremesa de Bulldozer solo activa uno de los 4 enlaces HT3 para comunicación con el chipset (los demás permanecen deshabilitados, en su versión Opteron se utilizan como conexión directa con hasta tres chips más).

La latencia L3 se me antoja como he comentado en numerosas ocasiones muy alta, creo firmemente que rondará los 50+ ciclos.

640_4

Ni rastro de las extrañas AGLU, ahora las llaman AGen, es decir una normal y corriente AGU. Además solamente hay dos pipes de enteros (INT pipes) una con circuitería MUL y la otra según AMD con un divisor por hardware (DIV). Viendo las latencias de división entera de Bulldozer me da la impresión de que tal divisor no existe y la división se ejecuta por micro código o tiene un diseño extremadamente simplificado y poco efectivo.

AMD Turbo Core en Bulldozer

En Bulldozer, AMD presenta un Turbo Core de dos niveles.

640_5

All Core Boost: Todos los módulos (conjuntos de dos cores con su SIMD FPU Unit y los 2 MB de L2) aumentan su frecuencia por encima de la nominal si el TDP y la temperatura lo permite.

Se da en cargas de trabajo que implique a TODOS los cores, sea con carga parcial elevada o máxima 100%.

Max Turbo Boost: Si dos de los módulos (cuatro INT cores, dos SIMD FPUs y dos L2 de 2 MB) se hallan en estado Sleep C6 (power gated) el resto (los otros dos módulos) pueden incrementar su frecuencia hasta en 1 GHz sobre la nominal.

Esto conlleva algunas consideraciones prestacionales extrañas y fastidiosas que detallaré cuando tenga hardware funcional comercial en las manos. A ver si en un mes y algo…

En múltiples artículos he analizado en detalle el diseño interno de BD 32 nm. Cito los más destacables:

AMD Bulldozer. Perspectivas – LowLevelHardware

La L3 cache multibanco en AMD Bulldozer. Actualizado – LowLevelHardware

AMD AGLUs, Bulldozer INT cores. Actualizado – LowLevelHardware

AMD Bulldozer. Primeros benchmarks. Actualizado – LowLevelHardware

AMD Bulldozer – ProfessionalSAT

La micro arquitectura de AMD Bulldozer. Actualizado – LowLevelHardware

Novedades y expectativas 2010. Actualizado – LowLevelHardware

AMD Bulldozer. Prestaciones estimadas – LowLevelHardware

Micro arquitectura AMD Bulldozer 2011. Actualizado – LowLevelHardware

Previo AMD Bulldozer. Actualizado – LowLevelHardware

Conclusiones

Poco se puede concluir hasta que no haya datos objetivos de steppings finales. Los actuales samples de Bulldozer son realmente lentos debido a numerosos bugs en los primeros steppings A y B1 que han hecho necesario deshabilitar características clave de las controladoras de memoria, cachés, TLBs, etc.

Queda ver como será Bulldozer con todos sus subsistemas a punto y cuales son las frecuencias finales comerciales. Sin duda estas no serán indicativas del verdadero potencial final en frecuencia de Bulldozer en 32 nm; AMD mejora sus procesos paso a paso a lo largo del tiempo en que este está en el mercado.

La historia fue realmente brillante en 90 nm cuando culminó en unos excelentes 3.2 GHz con el Athlon 64 X2 6400+ partiendo de los iniciales 1.8 GHz.

En el proceso de 65 nm SOI la historia fue diferente y empezó realmente mal. Los primeros Athlon 64 X2 eran claramente más lentos por ciclo (IPC) que los anteriores de 90 nm y les era imposible llegar a los 3 GHz. Con el tiempo llegaron a 3.1 GHz, un mal resultado e inferior al anterior de 90 nm SOI.

En aquel tiempo AMD lanzó Barcelona (Phenom) quad core también en 65 nm con unas frecuencias decepcionantes de 2.3 GHz en pico y una ridículamente pequeña caché L3 de 2 MB y elevada latencia. Con los meses llegó a 2.6 GHz y por fin llegaron los 45 nm.

Los 45 nm para AMD han sido un éxito rotundo, los Phenom II Shanghai subieron rápidamente de frecuencia y el incremento a 6M de la caché L3 le permitió ganar prestaciones por ciclo (IPC) respecto a Barcelona. A esto se añadió la excelente versión de 6 cores con Turbo Core, el Phenom II X6, también con 6 MB de L3.

Gracias al exitoso proceso de 45 nm AMD ha podido sobrevivir con un anticuado diseño de CPU que data de 2003, (remozado en 2007 con Barcelona, aunque igual en la parte de enteros) y esto lo escribo en Agosto de 2011…

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

AMD Bulldozer. Perspectivas – LowLevelHardware

Mucho se está hablando en los círculos informáticos acerca de la nueva micro arquitectura Bulldozer de AMD. Un diseño pensado para cargas de trabajo multithread y con pipelines de ejecución con mayor número de etapas para un alto potencial en frecuencia.

Orochi32nm_640AMD Orochi 32 nm 8 MB L2 y 8 MB L3.

En este artículo expondré algunas de mis opiniones sobre la micro arquitectura que va a marcar el futuro inmediato AMD de aquí a 2014.

AMD Bulldozer y el proceso de 32 nm HKMG SOI

En múltiples artículos he analizado en detalle el diseño interno de BD 32 nm. Cito los más destacables:

La L3 cache multibanco en AMD Bulldozer. Actualizado – LowLevelHardware

AMD AGLUs, Bulldozer INT cores. Actualizado – LowLevelHardware

AMD Bulldozer. Primeros benchmarks. Actualizado – LowLevelHardware

AMD Bulldozer – ProfessionalSAT

La micro arquitectura de AMD Bulldozer. Actualizado – LowLevelHardware

Novedades y expectativas 2010. Actualizado – LowLevelHardware

AMD Bulldozer. Prestaciones estimadas – LowLevelHardware

Micro arquitectura AMD Bulldozer 2011. Actualizado – LowLevelHardware

Previo AMD Bulldozer. Actualizado – LowLevelHardware

Bulldozer está fabricado por Global Foundries en el nodo de proceso de 32 nm HKMG (High K Metal Gate) SOI (Silicon On Insulator) lo que le dará unas buenas perspectivas de mejora de frecuencia y reducción de consumo con el paso del tiempo.

AMD a lo largo de su historia se ha caracterizado por ofrecer una continua mejora de su proceso de fabricación de semiconductores a los largo de la vida de cada nodo (para AMD unos 2 o 3 años).

Podemos decir que AMD saca al mercado los primeros chips en un nodo concreto (45 nm, 32 nm,…) cuando tiene unos yields (rendimientos de fabricación) mínimos (debido a la brutal presión competitiva de Intel) pero suficientes aún a costa de unas frecuencias de funcionamiento iniciales reducidas.

Con el paso de los meses AMD va mejorando paso a paso el proceso y se va reduciendo la disipación térmica, el voltaje y aumenta la frecuencia máxima de sus diseños.

GloFo32nm_640No es descabellado pensar en un 50% de mejora vs 45 nm para los 32 nm en AMD.

AMD Orochi Bulldozer. 4 módulos, 8 INT cores, 4 dual 128 FMACs y 2 MB L2

AMD Orochi va a rondar los casi 300 mm2 y está constituido por:

4 módulos completos.

4 bancos L3 de 2 MB y 16 vías (para un total de 8 MB L3 con 64 vías)

4 buses HT 3.0

2 controladoras DDR3 1866 MHz.

Un North Bridge.

El módulo en AMD Bulldozer

Frontend

Un módulo está integrado por:

2 INT cores con 2 ALUs y 2 AGUs, cada uno con su L1d de 16KB y 4 vías.

El Instruction Fetching desde la L1i compartida de 64KB y 2 vías.

La lógica de decoding de 4 vías con la Microcode ROM.

El circuitería de Branch Prediction.

La FPU doble de 128 bit FMAC (Fused Multiply Accumulate).

La unidad de control de caché que comprende las dos WCC (Write Combining Caches de 4 KB, una por INT core) que da acceso a la masiva cache L2 de 2 MB y 16 vías.

¿Qué podemos esperar de AMD Bulldozer?

Bulldozer al igual que Llano (la APU de 32 nm) se fabrican en el nuevo proceso y por ello sufrirán inicialmente de unas frecuencia máximas no muy elevadas.

Llano se ha estrenado a frecuencias máximas de 2.9 GHz, ahora está previsto que llegue al mercado una versión desbloqueada a 3.1 GHz con overclocks “sencillos” a 3.6 GHz.

Los cores de un Phenom II (al menos en los últimos steppings de 45 nm) llegan con relativa facilidad a los 4 GHz. A Llano esta frecuencia le queda lejos y eso que está fabricado en el siguiente nodo que debería proporcionar una mejora teórica de un 20% en frecuencia.

AMD 32 nm vs 45 nmDisipación térmica: AMD 45 nm vs 32 nm.

Recordemos que cuando AMD empezó a fabricar CPUs de 65 nm también padeció problemas claros de escalado de frecuencia, en concreto los primeros AMD K8 Brisbane funcionaban a 2.6 GHz cuando los “antiguos” K8 90 nm funcionaban sin problema a 3 GHz.

O pensemos en AMD Phenom Barcelona, fabricado en 65 nm en 2007 y que salió al mercado a unos meros 2.3 GHz cuando los K8 de la época (todavía de 90 nm) funcionaban a 3.2 GHz (Athlon 64 X2 6400+).

Conclusiones

Con esta coyuntura en mente podemos pensar lo siguiente según los diversos rumores y leaks que circulan:

Bulldozer, inicialmente en su configuración completa (Orochi) para socket AM3+ es deseable que ronde los 3.5 GHz nominales con carga 100% en los 8 cores y que gracias al Turbo logre frecuencias con carga de cores parcial (mitad de cores al 100%) rondando los 4 GHz.

AMD postula precios de unos 300 dólares para el top bin de Orochi, eso le sitúa en la banda de precios del Intel Core i7 2600K Sandy bridge: En mi opinión sería un éxito rotundo de AMD el posicionarse competitivamente en este nivel de precios.

A mí personalmente me cuesta creerlo pero sería una excelente noticia para la sana competencia en el sector.

En cualquier caso estamos a la vuelta de la esquina del lanzamiento previsto para Bulldozer, será en Septiembre si no hay cambio de planes. Para AMD sería una excelente noticia, y de paso dispararía su cotización bursátil, bastante deprimida tras los momentos gloriosos de los K7 y K8.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

La L3 cache multibanco en AMD Bulldozer. Actualizado – LowLevelHardware

Poco a poco se acerca la comercialización de los procesadores basados en la nueva micro arquitectura de AMD prevista para el 7 de junio. Actualización: finalmente llegará al mercado en Septiembre según los últimos roadmaps.

Bulldozer_32nm_640

Conforme pasan los días se va filtrando nueva información sobre su estructura interna y también algunos datos acerca de su rendimiento, o por lo menos del rendimiento de algunos Engineering Samples.

Bullzorer_ModuleBajo el módulo con su L2 de 2 MB se observa el banco de L3 de 2 MB y 16 vías.

En este artículo hablaré sobre la estructura de la caché L3 en Bulldozer y sobre su funcionamiento.

La caché L3 multibanco: 4 x 2 MB

AMD ha diseñado una caché L3 particionada en 4 sub arrays de 2 MB y 16 vías cada uno. la capacidad total en el chip de 4 módulos y 8 INT cores es de 8 MB y 64 vías de asociatividad.

El diseño es exclusivo, la L3 no incluye los datos presentes en la L2 de 2 MB de cada módulo y en cambio es una Victim Cache, donde se alojan las páginas desalojadas desde L2.

L3_1La frecuencia estimada para la L3 es de 2.4 GHz.

Con una frecuencia estimada en 2.4 GHz los anchos de banda son los siguientes:

  • 307.2 GB/s en lectura gracias a sus dos accesos por ciclo de 128 bit y por módulo.
    2 400 000 ciclos/s x 4 módulos x (2 accesos/ciclo x 128 bit) = 2 457 600 000 bit / 8bits/1 byte = 307 200 000 bytes/s = 307.2 GB/s
  • 153.6 GB/s en escritura gracias al acceso de 128 bit por ciclo.
    2 400 000 ciclos/s x 4 módulos x 128 bit = 1 228 800 000 bit / 8bits/1 byte =152 600 000 bytes/s = 153.6 GB/s

Por lo que se desprende de este documento, la caché L3 está conectada con cada módulo Bulldozer mediante dos buses de lectura de 128 bit y un bus de escritura de 128 bit. Se me antoja una mejora absolutamente espectacular respecto a anteriores diseños de AMD (un Phenom II X6, por ejemplo, solamente cuenta con un bus de 64 bit por core hacia y desde la L3 de 6 MB y 24 vías). De ahí sus mediocres resultados en este apartado.

Especulación 1. Espero latencias L3 elevadas en Bulldozer.

Teniendo en cuanta que la latencia efectiva L3 (load to use) es aditiva con la de los demás niveles y que la latencia L2 ya es conocida y va de los 18 a los 20 ciclos no será nada extraño que la latencia L3 efectiva en Bulldozer ronde los 50 ciclos.

Otro dato que apunta en la misma dirección es que se mantiene el diseño asíncrono con buffers de sincronización de Shanghai (Phenom II 45 nm), con una frecuencia de cores variable por los modos Turbo desde los 2.8 hasta los 3.5 GHz, será difícil conseguir bajas latencias L3.

Por último, una asociatividad tan elevada, 64 vías, aunque aumenta la tasa de aciertos L3, tampoco ayuda en cuanto a la latencia ya que hay que examinar 64 localizaciones cada vez en busca del dato o instrucción.

8 MB = 4 bancos de 2 MB y 16 vías

Una solución elegante que podría haber adoptado AMD consiste en que cada core tenga una latencia reducida de acceso hacia su banco local L3, es decir, que tenga “privilegio” de acceso a este banco y por ello mayor ancho de banda en GB/s y menor latencia en ciclos.

Bulldozer_32nm_L3_640

Esto sólo lo descubriremos en la práctica en cuanto le “echemos el guante” a un stepping final (comercial) de Bulldozer, lo tendremos el día 7 de Junio. Actualización: Bulldozer estará finalmente disponible en Septiembre si se cumplen las previsiones.

Conclusiones

AMD ha diseñado una caché L3 que marca un punto de partida desde sus actuales diseños de 45 nm y 6MB con 24 vías (Shanghai o Istambul). En Bulldozer son 4 bancos de 2 MB y 16 vías para un total de 64 vías.

Tengo ganas de probar un stepping final para ver si la latencia a cada uno de los bancos es diferente o por el contrario idéntica. Si existe una controladora de L3 para los 4 bancos será una latencia constante y elevada… en cambio, si cuenta (como Sandy Bridge) con una controladora L3 por cada banco de 2 MB pueden haber sorpresas.

En todo caso y con una L2 con 18 – 20 ciclos es difícil lograr latencias l3 muy recortadas. E s lógico esperar 10 ciclos más de latencia que en Sandy Bridge como mínimo (la L2 de SB tiene pipelines de 10 etapas Load to Use).

Destaca su optimización pensando en una baja disipación térmica y sobretodo en un consumo reducido, por ello su frecuencia rondará los 2.4 GHz y su voltaje estará sobre los 1.15 a 1.20 V efectivos. Es un diseño convencional, de bus con conectividad total entre todos los agentes, cada módulo Bulldozer y cada slice L3.

Hay que ser consciente del camino absolutamente divergente que ha adoptado Intel con Sandy Bridge 32 nm. La L3 es síncrona a los cores y funciona a la misma frecuencia que estos. Con ello consigue una bajísima latencia y un ancho de banda astronómico. Los diferentes bancos L3 se comunican entre sí mediante un ring bus bidireccional que aporta un gran ancho de banda y un funcionamiento “sencillo” a estos niveles.

Echad un vistazo a la web de mi nueva empresa, un proyecto de gran envergadura que llevo preparando hace más de un año.

Os lo recomiendo para diseño de sistemas de altas prestaciones optimizados al límite:

ip16_texto_300px_blanco422222

Allí tenéis a vuestra disposición el formulario de contacto, para consultas sobre este artículo hacedlo más abajo en la sección de comentarios.

Y mi nuevo Blog de contenido muy técnico y actualizado donde encontraréis artículos míos sobre hardware, procesadores y sistemas y también otros posts de expertos programadores e informáticos sobre otros temas de actualidad:

infromaticapremium-blog422222

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

AMD AGLUs, Bulldozer INT cores. Actualizado – LowLevelHardware

En este técnico artículo voy a detallar la estructura de los pipelines de ejecución de los INT cores duales de un módulo del nuevo procesador AMD Bulldozer.

int_clusterUno de los núcleos de enteros de Bulldozer.

AMD Bulldozer. Filosofía de diseño.

Con Bulldozer AMD ha roto con el diseño “convencional” para el núcleo de procesamiento. Hasta ahora, un procesador era un bloque que trabajaba conjunta y síncronamente compuesto de varias subunidades.

BulldozerAMD Bulldozer: Cada INT core y la unidad SIMD son funcionalmente independientes.

En cambio en Bulldozer, AMD ha seguido un diseño  CMT (Cluster Multi Processing) de coprocesamiento con subunidades independientes y con pipelines desacoplados mediante buffers y queues.

Las ventaja principal de esta disposición reside en la compartición de algunas estructuras entre los dos cores de enteros. Cada core ejecuta un thread, cada thread debería afinitizarse a un core para dar un óptimo rendimiento.

Aunque alguna de las unidades esté bloqueada procesando datos el Front End sigue ejecutando Fetching y computando los Branches llenando sus queues (colas) y buffers con resultados.

OrochiDie de Bulldozer con 4 módulos y 8 INT cores.

Resumiendo, con Bulldozer AMD construye un procesador multicore de 8 núcleos partiendo de una unidad que llaman el módulo que incluye 2 INT cores, la unidad SIMD y la L2 de 2 MB y 16 vías.

A lo largo de los dos últimos años he escrito varios artículos sobre AMD Bulldozer:

AMD Bulldozer. Primeros benchmarks. Actualizado – LowLevelHardware

AMD Bulldozer – ProfessionalSAT

La micro arquitectura de AMD Bulldozer. Actualizado – LowLevelHardware

Novedades y expectativas 2010. Actualizado – LowLevelHardware

AMD Bulldozer. Prestaciones estimadas – LowLevelHardware

Micro arquitectura AMD Bulldozer 2011. Actualizado – LowLevelHardware

Previo AMD Bulldozer. Actualizado – LowLevelHardware

AMD Bulldozer Front End.

El frontend de Bulldozer es compartido por todas las subunidades y está dimensionado y lógicamente desacoplado de las unidades de ejecución.

Cada módulo contiene un sólo Front End que da servicio a tres unidades de ejecución:

  • Los dos INT cores con 4 pipelines de ejecución cada uno y con su Scheduler y Register File privados.
  • La unidad SIMD compartida (llamada desacertadamente por AMD y la prensa especializada FPU compartida) con su Schedule y Register File.
    Yo la llamo unidad SIMD porque no sólo incluye (como detallaré en otro artículo) dos pipelines SIMD SSE, AVX y X87 sino también 2 unidades de 128 bit SIMD de enteros SSE y MMX (INT SIMD SSE y MMX).

FrontendEn rojo resaltado el Front End de AMD Bulldozer.

El Front End contiene entre otros:

  • La lógica de Branch Prediction que ha sido considerablemente rediseñada y ampliada de cara a aumentar su tasa de aciertos. Cuenta con un BTB de 2 niveles con miss penalties (penalización de fallo) de 15 a 20 ciclos en función del tipo de Branch.
  • Las etapas de fetching y decoding cargan datos (32 bytes/ciclo) desde las cachés L1i (64 KB, 2 vías) y alimentan dos ventanas de 16 bytes (una por thread). Hay un IBB (Instruction Byte Buffers) de 16 niveles en la cola de fetching por thread (2 IBBs, con cada 16 bytes por nivel).
    Los Decoders pueden decodificar hasta 4 instrucciones / ciclo desde los IBB, cada ciclo se escanean dos de las ventanas de 16 bytes en busca de hasta cuatro instrucciones. En caso de instrucciones X86 complejas que hagan recurrir al Microcode Engine solamente se decodifica una instrucción por ciclo.

Bulldozer INT cores. Unidades de enteros.

Cada unidad de enteros es como un pequeño core de ejecución de 64 bit con 4 pipelines discretos alimentados por un Scheduler independiente.

INTcoresEn verde y azul los dos INT cores de un módulo Bulldozer.

El núcleo de ejecución consta de 4 pipelines de 64 bit con un diseño peculiar y novedoso que incluye las unidades combinadas AGLU:

Bulldozer_INT_PIPESCuatro unidades de ejecución de enteros con Scheduler común.

La longitud de los pipelines de enteros ha crecido en Bulldozer de un modo espectacular hasta las 18 o 20 etapas. Comparado con las 12 etapas de AMD Phenom destaca como un diseño claramente dirigido a altas frecuencias que en mi modesta opinión sólo tiene sentido si supera con claridad los 4 GHz en modos Turbo para compensar su gran penalización en caso de fallo de predicción Branch.

INT_cores

Los dos INT cores que forman parte de un módulo en AMD Bulldozer.

Lo novedoso de los INT cores son sus unidades híbridas AGLU:

Son unidades AGU (de generación de direcciones de memoria, address generators) pero con funciones básicas ALU, es decir, pueden procesar instrucciones simples ALU (LEA 64, INC) echando una mano para compensar el escaso ancho de proceso del core.

int_cluster_AGLUSResaltadas las dos AGLUs pertenecientes a uno de los INT cores.

Las unidades de ejecución completas (Full ALU) EX0 y EX1 incluyen hardware específico para IMUL e IDIV:

  • EX0 contiene una unidad de división de enteros parcialmente pipelinizada y con latencia y capacidad de proceso variable en función de la precisión. Aunque examinando detenidamente la documentación parece que más bien se trata de una unidad “virtual” ya que la instrucción IDIV se decodifica en el Microcode Engine y se secuencia en instrucciones sencillas ALU que se ejecutan en EX0. Además incluye una unidad para LZCNT y POPCNT.
  • EX1 por su parte contiene un rapidísimo multiplicador de enteros pipelinizado y de bajísima latencia.
  • Ambas unidades procesan Branches e instrucciones de enteros complejas.

Cada INT core cuenta con su Scheduler discreto e independiente y ejecuta un thread, además supervisa el procesamiento en las unidad SIMD compartida de las instrucciones FPU X87, FPU SIMD SSE / AVX  o INT SIMD MMX / SSE.

Conclusiones

El diseño de Bulldozer me deja un sabor agridulce, AMD sin duda ha dado un paso adelante y si consigue ponerlo en el mercado a frecuencias adecuadas (4 GHz o más en Turbo Mode) tendrá un procesador globalmente competitivo con Sandy Bridge.

Hay detalles que sinceramente no me acaban de convencer como algunas latencias muy elevadas en algunas instrucciones y sin duda será inferior a Sandy Bridge en proceso FPU AVX 256 bit.

Bulldozer puede ser un excelente procesador en cargas de enteros de 8 threads, queda la incógnita acerca del rendimiento de su caché L3 y el subsistema de memoria.

Las latencias L3 serán altas, creo que superiores a los 50 ciclos load to use, razonable me parecen 60 incluso. Hay que ver como compensa efectivamente el Hardware Prefetch este hecho. La elevada latencia L2 (de 18 a 20 ciclos) la compensa parcialmente su gran tamaño (Sandy Bridge se conforma con 256 KB, 8 veces menos, pero con latencias de 9-10 ciclos).

Tengamos en cuenta que la frecuencia del Uncore que incluye la caché L3 multibanco (4 bancos de 2 MB) de 8 MB será muy inferior a la de los cores, probablemente se mueva sobre los 2.4 – 2.66 GHz lo que afectará a la latencia L3 y de memoria.

El panorama en 2011 será divertido… nos vemos en la próxima entrega con un análisis de la unidad SIMD de 4 vías compartida de proceso FPU SSE / AVX / X87 y INT SIMD SSE / MMX.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.

AMD Bulldozer. Primeros benchmarks. Actualizado – LowLevelHardware

Mucho se ha hablado en los últimos días de los resultados prestacionales aparecidos en internet de dos Engineering Samples del nuevo procesador AMD Bulldozer.

OrochiDie de Bulldozer con 4 módulos y 8 INT cores.

Los resultados han aparecido en OpenBenchmarking.org. Se trata de la versión para servidores (Opteron) de Bulldozer, en unas máquinas configuradas con 2 chips Magny Cours (MCM de dos dies de 8 INT cores cada una, total por chip: 16 INT cores) para un total de 32 INT cores:

http://openbenchmarking.org/s/AMD%20Eng%20Sample%20ZS182045TGG43_2

http://openbenchmarking.org/s/AMD%20Eng%20Sample%20ZS182045TGG43_28

obo-logo-header[1]

Debo expresar mis reservas sobre, no tanto la veracidad de los resultados, si no sobre la representatividad de estos datos. Por lo que se deriva del análisis de las puntuaciones en estos benchmarks, está claro que es un stepping muy temprano de Bulldozer, funcionando sobre placas base pre-release y con BIOS sin optimización alguna.

Los hechos que apuntan a estas conclusiones son,principalmente, el ínfimo rendimiento en algunos de los tests que afectan al subsistema de memoria.

Es muy posible que en estos procesadores haya algunas características clave desactivadas o deshabilitadas que degradan terriblemente el rendimiento. Algunos de las unidades previsiblemente desactivadas son los siguientes:

  1. El Probe Filter, encargado de reducir el tráfico de coherencia entre las cachés de cada die. Recordemos que en los sistemas de pruebas hay dos CPUs MCM (Multi Chip Module) para 4 dies en total (32 INT cores y 16 nódulos).
  2. El último nivel de los TLB.

Los resultados de Stream son tan bajos que claramente apuntan en esta dirección: unos meros 6 GB/s.

Un sistema equivalente actual de AMD con dos chips Magny Cours (MCM de dos dies de 6 cores. 12 cores en total por chip. 24 cores por sistema) supera los 27 GB/s en el mismo test.

Bullzorer_ModuleUno de los módulos de Bulldozer con 2 INT cores y sus cachés L2 2 MB y L3 2 MB.

Otras dudas que me asaltan sobre estos chips ES son las siguientes:

  1. ¿Estará activado o no el Turbo Mode? Yo personalmente abogo por que no. El variar la frecuencia de una CPU en funcionamiento no es precisamente un proceso sencillo. Exige mucha validación y tunning de BIOS así como de la parte eléctrica de la placa base y no suele estar disponible hasta los steppings finales.
  2. La frecuencia del uncore o North Bridge que comprende los cuatro bancos de 2 MB de caché L3 es desconocida y con seguridad muy inferior a la final.
  3. ¿Se hace uso de AVX en el código del conjunto de pruebas? Y si es es así, en qué modo.

Seguramente la frecuencia de 1.8 / 1.9 GHz apuntada en los resultados sea fija y no aumente los 500 MHz que AMD ha estipulado para el Turbo Mode en Bulldozer con carga full threaded.

Bullzorer_Module_CroquisDistribución de unidades en un módulo de Bulldozer.

Frecuencias probables de las versiones comerciales

Las frecuencias finales de los Opteron Interlagos (MCM de 2 dies de 8 INT cores en un chip) de 16 INT cores (8 nódulos) probablemente rondarán inicialmente los 2.4 – 2.8 GHz más los 500 MHz en carga gracias al Turbo.

En los diseños de sobremesa, el octal core (8 INT cores, 4 módulos) es razonable y deseable que al menos esté sobre los 3.0 – 3.4 GHz inicialmente. Me queda la duda sobre la frecuencia del North Bridge y los 4 bancos de L3 de 2 MB, lo lógico sería que no bajase de los 2.4 GHz.

Pequeño apunte, prestaciones

En proceso de enteros, Bulldozer parece ser un buen diseño multithread pero con graves limitaciones en código single threaded comparado con Sandy Bridge.

En coma flotante X87 o SSE no romperá records de velocidad en cálculo paralelo, aunque tendrá un excelente rendimiento single threaded.

La posición de Bulldozer en el mercado de CPUs dependerá principalmente de la frecuencia final del diseño. Si el octal core de sobremesa se queda en los 3.2 GHz (más los 500 MHz del Turbo) pasará serias dificultades frente a Sandy Bridge E (la versión para expertos de SB, prevista para Q4 de 2011).

Si se acerca a los 4 GHz podrá plantarle cara en igualdad de condiciones.

Conclusiones

Poco puedo sacar en claro de estos escasos datos inconexos y con un extrema falta de contexto. Es prácticamente desconocida la información sobre la configuración hardware y software y sobre las condiciones de las pruebas.

En mi opinión estos primeros resultados constituyen una guía y más bien un umbral mínimo en las prestaciones de los steppings comerciales de Bulldozer.

Una observación que me impresiona y sorprende al analizar los datos es que en algunos tests Interlagos mejora los resultados de Magny Cours hasta en un 28 % pero en otros obtiene una velocidad de solamente un 60% (normalizando Magny Cours al 100%).

Me recuerda a los benchmarks de los sistemas Pentium 4 comparados con los AMD Athlon o Pentium III… Esperemos que solo sea una desafortunada primera impresión… Aunque mis análisis micro arquitecturales de Bulldozer hasta la fecha apuntan en esta dirección.

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes.