Mostrando entradas con la etiqueta Athlon64. Mostrar todas las entradas

sábado, 21 de junio de 2008

Lo nuevo de AMD: BGA CPU

Parece que el fabricante con base en Dresden va a desarrollar un procesador destinado a MIDs, UMPCs y portátiles del segmento del exitoso Asus Eee PC.

AMD, debido a sus dificultades económicas no puede permitirse como su rival, Intel Corp, diseñar un nuevo procesador desde cero y por ello ha adaptado el conocido Athlon64 a los requerimientos de los dispositivos móviles.

amd-bgacpu

Basado en el núcleo Athlon64, aquí tenéis los detalles:

  • Arquitectura de 64 bit
  • Controladora de memoria de un canal DDR2 400
  • Bus HyperTransport @ 800 MHz
  • L1i 64 KB, L1d 64 KB
  • Frecuencia 1 GHz
  • TDP 8W
  • Encapsulado 27 x 27 mm y 812 pines

Las medidas de AMD para reducir el consumo respecto al Athlon64 del que deriva son:

  • Reducción drástica de la frecuencia de núcleo a 1 GHz
  • Reducción del multiplicador de HT a 4
  • Se prescinde del segundo canal de memoria
  • Reducción de la frecuencia máxima de la DDR2 de 800 a 400 MHz
  • Reducción del tamaño de L2 a 256 KB

Todas estas medidas permitirán al fabricante reducir considerablemente el voltaje de núcleo con el consiguiente ahorro energético y ampliación de la vida de la batería en los dispositivos a los que va dirigido.

Muy probablemente sea un dispositivo de 65 nm, aunque depende de cuando salga al mercado. El sentido práctico indica que será de 65 nm y no 45 nm pues AMD ya dispone hace tiempo de cores Athlon 64 Brisbane de 65 nm, la dificultad de diseño disminuye drásticamente.

Deberá competir con los Intel Celeron-M y Atom y con los VIA Nano y C7-M:

  • El Intel Celeron-M es un procesador single core basado en la arquitectura Core2, con altas prestaciones por ciclo, FSB de 533 MHz  y 1 MB de L2. Sus TDP rondan los 27 a 31 W.
  meromdieim
  • El Intel Atom es una microarquitectura totalmente nueva, diseñada específicamente en cada detalle para reducir al mínimo indispensable el consumo. Integra SMT y habrá versiones dualcore. Su TDP mínimo es de 2W (!!).


  • El VIA C7-M es un chip ya veterano de VIA. Se presenta en dos versiones C7-M con TDPs de 12 a 20W y C7-M  ULV con TDPs de 3.5 a 7.5 W y está fabricado en el nodo de 90 nm.
VIA C7-M Mobile Processor LogoVIA C7-M Mobile Processor
  • El VIA Nano es un nuevo diseño de VIA en 65 nm. Es un núcleo de altas prestaciones, por ahora single core. Cuenta con 1 MB de L2 y TDPs de 5 W a 1 GHz y 25 W a 1.8 GHz.

Image1

Sin olvidar los nuevos nVidia Tegra basados en arquitectura ARM11.

[8267_nvidiategradt12.jpg]

La competencia es el mayor estímulo del progreso y está claro que en los dispositivos móviles va a haber una verdadera revolución a la que ya estamos asistiendo.

Etiquetas de Technorati: ,,,

domingo, 18 de mayo de 2008

El TLB secreto de AMD. Parte III.

En los dos artículos anteriores (1, 2) hemos introducido la existencia de una estructura oculta, no documentada en las controladoras de memoria integradas en los procesadores AMD K8 y K10. En este artículo analizaré 3 procesadores, dos A64 X2 AM2 y el Phenom 9600 BE con el TLB patch activado y sin el.

Controladora de memoria de 128 bit DDR de un AMD A64 939 130nm.


Controladora de memoria de 128 bit DDR de un AMD A64 X2 939 90nm.
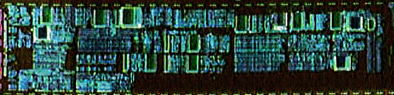

Controladora de memoria de 128 bit DDR2 de un AMD A64 AM2 65nm.


La motivación de esta serie de artículos es conocer más a fondo el comportamiento de las controladoras de memoria integradas de los procesadores AMD, gracias a su integración en el procesador han obtenido ventajas competitivas importantes y han podido mantener en el mercado arquitecturas obsolescentes (léase K8 Athlon64) frente a los nuevos y más depurados núcleos de la serie Core2 de Intel.

Sistemas probados:

Sistema AM2:

  • Placa Gigabyte MA-790X DS4 R1.0 AM2+
  • 1 x 2 GB DDR2 800 5-6-6-18 Kingston HyperX
  • AMD A64 X2 5600+ Brisbane G2, 65 nm, 2.9 GHz, 2 x 512 KB L2
  • AMD A64 X2 5600+ Windsor F2, 90 nm, 2.8 GHz, 2 x 1024 KB L2

Sistema AM2+:

  • Placa Gigabyte MA-790X DS4 R1.0 AM2+
  • 2 x 1 GB DDR2 1066 @ 800 4-4-4-12-1T Kingston HyperX
  • AMD Phenom 9600 Barcelona B2, 65nm, 2.3 GHz, 1.8 GHz NB, 4 x 512 KB L2, 2048 KB L3
  • Con el TLB BIOS Patch aplicado y sin él.

Para mayor información sobre el TLB patch, errata 298 y los stepping B2 y B3 de AMD Barcelona recomiendo leer este artículo anterior.

Resultados experimentales


Todos los resultados y gráficas obtenidos con el software RMMA 3.8, descarga.


RightMark Memory Analyzer 3.8.

Athlon64 X2 5600+ Windsor, F2, 90 nm, 2.8 GHz, 2 x 1 MB L2

D-TLB test de 16384 entradas. Tamaño tercer D-TLB 16384 entradas.

Test I-TLB de 16384 entradas. Tamaño tercer I-TLB 16384 entradas.

L2 D-TLB miss latency: sobre 38 ciclos.

Tercer nivel D-TLB miss latency: más de 100 ciclos. Tamaño estimado 16384 entradas.

L2 I-TLB miss latency: sobre 40 ciclos.

Tercer nivel I-TLB miss latency: más de 280 ciclos. Tamaño estimado 16384 entradas.

Athlon64 X2 5600+ Brisbane, G2, 65 nm, 2.9 GHz, 2 x 512 KB L2

Test D-TLB de 16384 entradas. Tamaño tercer D-TLB 8192 entradas.

Test I-TLB de 16384 entradas. Tamaño tercer I-TLB 8192 entradas.

L2 D-TLB miss latency: sobre 42 ciclos.

Tercer nivel D-TLB miss latency: más de 260 ciclos. Tamaño estimado 8192 entradas.

L2 I-TLB miss latency: sobre 56 ciclos.

Tercer nivel I-TLB miss latency: más de 340 ciclos. Tamaño estimado 8192 entradas.

AMD Phenom 9600 Barcelona B2, 65nm, 2.3 GHz, 1.8 GHz NB, 4 x 512 KB L2, 2 MB L3 sin TLB BIOS Patch

Test D-TLB de 16384 entradas. Tamaño del tercer D-TLB 8192 entradas.

Test I-TLB de 16384 entradas. Tamaño tercer I-TLB 4096 entradas.

L2 D-TLB miss latency: sobre 52 ciclos.

Tercer nivel D-TLB miss latency: más de 100 ciclos. Tamaño estimado 8192 entradas.

L2 I-TLB miss latency: sobre 68 ciclos.

Tercer nivel I-TLB miss latency: más de 150 ciclos. Tamaño estimado 4096 entradas.

AMD Phenom 9600 Barcelona B2, 65nm, 2.3 GHz, 1.8 GHz NB, 4 x 512 KB L2, 2 MB L3 con TLB BIOS Patch

Test D-TLB de 16384 entradas. El tercer D-TLB ha perdido su eficacia.

Test I-TLB de 16384 entradas. El tercer I-TLB ha perdido su eficacia.

L2 D-TLB miss latency: sobre 387 ciclos.

Tercer nivel D-TLB miss latency: más de 460 ciclos. Tamaño estimado 8192 entradas.

L2 I-TLB miss latency: sobre 414 ciclos.

Tercer nivel I-TLB miss latency: más de 460 ciclos. Tamaño estimado 8192 entradas.

Conclusiones y comentarios

Como podemos ver en los gráficos y en los resultados hay tres hechos importantes a señalar:

  • Los A64 X2 del antiguo core Windsor de 90 nm son más rápidos y eficientes en relación a la memoria (y tambien con la caché L2). Sus miss penalties (latencia acumuladad en caso fallo del TLB) son siempre menores, a veces 3 veces inferiores.
  • Los Phenom stepping B2 sufren una brutal degradación en su velocidad y latencia de memoria debido a una gradísima penalización en caso de fallo de sus L2 TLBs.
  • Por último queda demostrada la existencia de una estructura a modo de gran TLB o tercer nivel TLB, tanto para instrucciones como datos y que mitiga la penalización en caso de fallo de los L2 TLBs. Su tamaño es variable, entre 4K entradas y 16K entradas según las pruebas.

Como comentario final, puntualizar que el TLB Patch disminuye la eficiencia de este gran TLB prácticamente a cero, provocando miss penalties en el entorno de los 400 (!!) ciclos de CPU en caso de fallo de los L2 TLB.

Parece demostrado que el fallo que provoca la errata 298 está localizado físicamente en esta estructura oculta localizada en la controladora de memoria integrada.

Podemos decir que por fortuna AMD ha tardado poco en ultimar y comercializar su core Barcelona B3, libre ya del infame TLB bug o errata 298. Recordemos que los primeros diseños de Shanghai 45 nm también poseen este defecto y AMD ha tenido también que modificarlos y ello retrasará en alguna medida su time to market.

Para una descripción de la arquitectura del AMD Phenom, consulte este artículo.

Pra un análisis y discusión de errata 298 y los stepping B2 y B3, consulte este enlace.

domingo, 11 de mayo de 2008

El TLB secreto de AMD. Parte II.

En esta segunda parte desvelamos los resultados experimentales que prueban la existencia de una estructura oculta en las controladoras de memoria integradas en toda la gama K8 y K10. Aquí nos centramos en el Athlon64 X2 de 90nm core Manchester de socket 939 con dos canales DDR 400.


Die del Athlon64 X2 1 + 1 MB L2. Pulsa para ampliar.


Sistema de pruebas:
  • Athlon64 X2 3800+ S939 Manchester (512 + 512 KB L2) @ 2.5 GHz.
  • 2 x 1 GB Kingston HyperX DDR 400 @ 2.5 3 3 8 1T.
  • Frecuencias de memoria: 416 MHz dual channel.

Resultados RMMA 3.8:


RMMA D-TLB test. Pulsa para ampliar.

Vemos el comportamiento normal:

  • Hasta los 32 bloques actúa el L1 D-TLB con su bajísima latencia (unos 3 ciclos totales)
  • De 32 a 512 bloques actúa el L2 D-TLB con unos 8 ciclos de latencia.

De aquí en adelante empieza el comportamiento anómalo:

  • De 512 bloques en adelante la latencia va aumentando hasta estabilizarse en unos 40 ciclos en el rango de los 1536 a 8192 bloques. ¿Será un L3 D-TLB? Pero si no hay caché L3, este super-TLB se encuentra en la controladora de memoria y tiene una miss penalty de más de 100 ciclos, es decir, en caso de fallo se incurre en una penalización en el cálculo de la dirección física de memoria de más de 100 ciclos.
  • De 8192 bloques en adelante la latencia aumenta hasta los 200 ciclos aproximadamente.

Funcionamiento de los niveles de TLB:

  • Si se da un fallo de L1 D-TLB y un acierto de L2 D-TLB se acumula una latencia de 5 ciclos, resultando una latencia total de unos 8 ciclos (latencia caché L1 + L1 D-TLB miss penalty).
  • Si se da un fallo de L2 D-TLB se acumula una latencia de unos 17 ciclos más, dando una latencia efectiva máxima de unos 40 ciclos.

Como podemos ver hay alguna estructura fuera del núcleo de ejecución que reduce la penalización del fallo del L2 D-TLB hasta un tamaño de 8192 bloques a un máximo de solamente unos 40 ciclos.

Por encima de los 8192 bloques la latencia aumenta hasta los 200 ciclos, típica latencia de acceso a memoria en modo aleatorio (random) con fallo de TLB.

RMMA I-TLB test. Pulsa para ampliar.

En el caso del I-TLB los resultados son análogos, con latencias algo superiores.

Conclusiones:

La controladora de memoria de los microprocesadores Athlon64 X2 en su versión de 90 nm contiene un gran TLB, eficaz tanto en operaciones con datos como con instrucciones y con un tamaño efectivo de unos 8192 Bloques.

Su missprediction penalty es mayor de 100 ciclos, pero siendo sinceros, su tasa de fallos debe ser ínfima, cercana a cero.

Ahora nos queda resolver el enigma de las bajas prestaciones de Brisbane y el origen del TLB bug de los Barcelona stepping B1 y B2. Serán cuestiones para el siguiente artículo.

El TLB secreto de AMD. Parte I.

En este artículo desvelamos una estructura oculta en las controladoras de memoria integradas en toda la gama de procesadores AMD desde el primer K8 Athlon64 de 130 nm hasta los actuales AMD K10 Barcelona de 65 nm. En esta primera parte analizo el aspecto teórico del problema, en el segundo y tercero los resultados experimentales.


D-TLB test de RMMA con tamaños hasta 16 MB. ¿Otra inflexión en 8192 KB?

¿Qué es el TLB?

El TLB o Translation Lookaside Buffer es una caché que almacena las traducciones de memoria virtual (con las que internamente trabaja el procesador) a memoria física. Las direcciones de memoria física son las direcciones de la RAM del sistema.
Al igual que con las cachés tradicionales, los TLB se pueden dividir entre datos e instrucciones y puede haber varios niveles de TLB.
.
El TLB hace referencia en sus tablas a direcciones físicas, contiene entradas de las Tablas de Paginación (PTE, Page Table Entry) del sistema operativo. Las tablas de paginación son utilizadas por el subsistema de memoria virtual del sistema operativo y mantienen una relación de correspondencia entre entradas de memoria virtual (paginación) y memoria física (RAM).
.
Los TLB tienen un tamaño limitado (KB), una asociatividad (en vias, ways) y una tasa de aciertos con su latencia de fallo (miss penalty o missprediction latency).
.
El núcleo AMD K8:
.
El AMD K8 fue un procesador que marcó una época, arrasó a la competencia de su archirival Intel y se convirtió en el rey en los segmentos de consumo y estaciones de trabajo / servidores. Marcó unos años dulces y de grandes beneficios para AMD , lo que se reflejó en su cotización bursátil.
.
El primer núcleo K8 (130 nm, 1 MB L2). Fuente: AMD. Pulsa para ampliar.
.
El revolucionario concepto de la controladora de memoria integrada, primicia en el mundo x86, disparó brutalmente las prestaciones del núcleo K8, que no era más que un AthlonXP remozado y mejorado.
.
El K7 siempre adujo de elevadas latencias en su subsistema de memoria, una caché L2 muy lenta y con alta latencia y un hardware prefetch ineficiente con una implementación simplista hacían del AMD Athlon un gran procesador ávido de datos e instrucciones.
.
Llegó el chipset nVidia nForce2 con dual channel DDR 400. NForce2 incluía en su Northbridge un "preprocesador", se encargaba de predecir los accesos a memoria del AthlonXP realizando lecturas especulativas en ambos canales de memoria. AthlonXP llegó a mejorar un 10% sus prestaciones gracias a nForce2.
.
K8 acabó con la gran limitación de K7 y lo hizo a lo grande. Integró la controladora de memoria en la cpu:


Núcleo del AMD K8 130 nm. Abajo podemos ver la controladora de memoria.

La implementación TLB de AMD K8 es como sigue:
  • L1 D-TLB: 32 / 4 entradas. Full associative. Miss penalty de 5 ciclos.
  • L1 I-TLB: 32/ 4 entradas. Full associative. Miss penalty de 4 ciclos.
  • L2 D-TLB: 512 entradas. Asociatividad de 4 vías. Miss penalty de 17 ciclos.
  • L2 I-TLB: 512 entradas. Asociatividad de 4 vías. Miss penalty de 25 ciclos.
Captura de RMMA, RightMark Memory Analyzer. Descarga.

Podemos decir que es una implementación bastante potente. Claramente superior a la de su competidor, el Intel Pentium 4 core Willamette/Northwood/Prescott.
.
El núcleo AMD K10 Barcelona 65 nm:


Arquitectura del AMD Barcelona Quadcore 65 nm.

.

Bloques funcionales del AMD Barcelona 65nm.

Implementación TLB en AMD Barcelona:

  • L1 D-TLB: 48 entradas. Full associativity. Miss penalty 5 ciclos.
  • L1 I-TLB: 48 entradas. Full associativity. Miss penalty 4 ciclos.
  • L2 D-TLB: 512 / 128 entradas. Asociatividad 4 vías. Miss penalty 28 ciclos.
  • L2 I-TLB: 512 / 128 entradas. Asociatividad 4 vías. Miss penalty 36 ciclos.

AMD y los 65 nm:

Este texto está tomado del siguiente artículo en este mismo sitio: http://lowlevelhardware.blogspot.com/2008/03/peculiaridades-microarquitectura-phenom.html.

Los micros Athlon64, inicialmente de 130nm, lograron una exitosa migración a los 90nm con el famoso núcleo Venice en los tiempos que Intel sufría con su core de 90nm, Prescott. Venice era mejor clock for clock respecto al Athlon64 original, consumía menos, escalaba mejor en frecuencia y dió a AMD una ventaja competitiva importante.

No sucedió lo mismo con la transición a 65nm. Actualmente los micros de mayor frecuencia de AMD todavía se fabrican con tecnología de 90nm (léase A64 6400+ a 3.2GHz, 2 L2 de 1MB). La misma CPU fabricada en 65nm (Brisbane 2L2 de 512KB) ráramente escala pasados los 3GHz (por otro lado Brisbane es algo más lento a la misma frecuencia).

Posiblemente sea la falta de recursos (económicos y técnicos) para la optimización y correcta migración al proceso de 65nm, pero estos son los hechos. Recordemos la bajísima capitalización actual de AMD (Nasdaq: AMD) en bolsa y la adquisición de ATI a un precio que luego se ha visto excesivo.

La gran superficie y alto coste del chip ha marcado el tamaño de sus cachés. La L2 es de 512 KB, cuando los Athlon64 de gama alta gozan de 1MB por procesador. En cuanto a la L3, solamente 2MB para cuatro núcleos se antoja una cantidad insuficiente, dado lo extendido del software multithread y el uso del PC en los sistemas operativos actuales. Esto es en parte compensado por su alta asociatividad de 32 vías que aumenta la tasa de aciertos.

Los K8 de 65nm, AMD Brisbane:

Brisbane es el stepping G del Athlon64 X2 AM2 con controladora de 128 bit DDR2 800, sustituye al stepping F, el primer AM2.

Todo el mundo conoce el hecho siguiente: un procesador AMD Athlon64 X2 de 65nm (core Brisbane) es más lento por ciclo que uno de la generación anterior de 90 nm. Empeora la velocidad de la caché L2, empeora su latencia y aumenta catastróficamente la latencia de memoria en accesos aleatorios (random).

¿Porqué es más lento Brisbane clock for clock que sus antecesores de 90 nm?

¿Qué ha ocurrido en la migración del núcleo K8 a 65nm?

¿A qué se debe el TLB bug de los primeros AMD Barcelona?

En la siguiente entrega analizamos el núcleo K8 en su variante de 90 nm, core Manchester. En la tercera analizaremos el core Barcelona que podemos encontrar en los Phenom y Opteron. quadcore de 65 nm.

Descarga de RMMa 3.8.

Página de DigitLife, desarolladores de RMMA.