viernes, 30 de mayo de 2008

Baterías de litio explosivas

Las celdas de Li-ion han significado una revolución en la portabilidad (por su baja densidad) y duración de batería de numerosos gadgets, teléfonos móviles, PCs portátiles y otros.

Tienen una densidad de energía muy alta por gramo, apenas padecen el "efecto memoria", todo parecen ventajas ...

Pero también tienen un pero: Su peligrosidad.

El litio (Li, número atómico 3) es un metal alcalino, altamente reactivo con el aire o el agua, se oxida con violencia, a veces en forma explosiva.

Las baterías de litio están compuestas de celdas, a mayor número de celdas, mayor capacidad en mAh y destacan por su ligereza, tres veces la del NiCd / NiMH.

Para conservar su capacidad se deben observar precauciones en cuanto a temperatura:

  • Al cargar: de 0 a 45ºC.
  • Almacenamiento: 0 a 20ºC. Solamente hasta 20ºC (!!)

El problema de los incendios o explosiones, se debe a la alta tasa de descarga que producen en las baterías los modernos dispositivos de alto consumo, lo que produce sobrecalentamiento y fallo de los sellados, entrada de aire y reacción química exotérmica ...

Suele ser fruto del ahorro de costes, el mal aislamiento entre celdas, y la mala conductividad térmica de los encapsulados empleados.

Redordemos que normalmente las celdas las produce algún fabricante de primera línea conocido en algún país occidental / industrializado pero su ensamblaje, encapsulado y sellado se hace en paises como China que adolecen de falta de controles de calidad y seguridad ... que se lo digan a Mattel!

Perfmonitor. Introducción

Perfmonitor es una aplicación muy sencilla que permite acceder a los performance counters de cada core del procesador de nuestro sistema.

 Image1

4 instancias de PerfMonitor en Core2Quad. Sistema idle.

Los performance counters son registros internos del procesador que miden y almacenan parámetros críticos del funcionamiento del núcleo de ejecución, cachés, TLBs, uso del FSB, memoria, ... cualquier dato imaginable, lo dificil es acceder a ellos.

Image2

4 instancias de Perfmonitor en Core2Quad Prime95 small FFTs.

Con PerfMon esto es sencillo, descomprimimos el software, ejecutamos y listo.

Image3

Opciones de click izquierdo para Core2Quad.

Para un análisis pormenorizado de cada uno de los performance counters en dos arquitecturas diferentes vea la segunda y tercera parte del artículo.

viernes, 23 de mayo de 2008

Sobre la cache de Nehalem

En un artículo anterior hice una extensa discusión sobre la siguiente microarquitectura de Intel, conocida como Nehalem. Aquí querría puntualizar algunos hechos sobre su estructura de cache y aventurar algunas posibilidades en cuanto a latencias.

Die de Nehalem quad core.

Las caches de Nehalem quad core son:

  • Cache L1i: 32 KB, 4 vías.
  • Cache L1d: 32 KB, 8 vías, dual ported. Latencia 4 ciclos.
  • Cache L2: 256 KB, 8 vías, baja latencia.
  • LLC, Cache L3 UNIFICADA para 4 cores: 8 MB compartida para los 4 cores, 16 vías.

En los Core 2:

  • Cache L1i: 32 KB, 8 vías.
  • Cache L1d: 32 KB, 8 vías, dual ported. Latencia: 3 ciclos.
  • LLC, Cache L2 UNIFICADA para 2 cores: 2 o 4 MB o 3 o 6 MB según versión del núcleo. Latencia 14 o 15 ciclos.

Como comenté en su momento, Nehalem cuenta con una arquitectura de cache inclusiva, es decir, los datos residentes en L1 están copiados en L2 y los de L2 también en L3.

Esta distribución tiene ventajas (poco tráfico de coherencia de L1 y L2 internúcleo) y desventajas (tamaño efectivo de caché igual al tamaño del LLC o último nivel de caché).

Caches L2 privadas de baja latencia de 256 KB

Las L2 independientes o privadas para cada core, aportarán un almacenamiento de tamaño intermedio y de muy baja latencia según Intel.

Intel asegura que tendrán latencias Load to use inferiores a 12 ciclos, yo espero razonablemente que más bien estén en el entorno de los 10 ciclos.

Cache L3 compartida de 8 MB

La latencia de la L3 en Nehalem será comparable a la de AMD Barcelona o AMD Shanghai, es decir muy elevada.

La latencia efectiva de Barcelona se sitúa en el rango de los 48 ciclos. Según los ingenieros de Intel, la L3 de Nehalem andará por los 30 ciclos en el caso óptimo y más de 40 en el caso general.

Extraído de:

http://lowlevelhardware.blogspot.com/2008/03/peculiaridades-microarquitectura-phenom.html

Como anteriormente señalamos, tenemos dos frecuencias diferenciadas y un flujo de datos bidireccional entre ambos dominios de reloj. Lo que acarrea latencias de sincronización, un conocido enemigo del rendimiento. Es el precio a pagar por mantener a raya el consumo.

La "extrañamente" elevada latencia de la caché L3 (sobre los 49 ciclos) y la degradación de algunos parámetros de acceso a memoria respecto a su antecesor, el K8 (empeora ligerísimamente la latencia de memoria principal) se explican por esta asincronía.

La adición de un tercer nivel de caché tiene ventajas e inconvenientes, entre las ventajas destacaremos la coherencia de los datos de los cuatro núcleos al nivel de L3, ahorrando tráfico a las controladoras de memoria y como desventajas la adición del chequeo de L3 en los accesos a memoria. (En los K8 no era necesario puesto que no había L3).

En resumen, con Nehalem Intel prosigue su imparable ritmo de mejoras microarquitecturales a un paso hoy por hoy imposible de seguir por sus competidores.

jueves, 22 de mayo de 2008

Cores y pasta térmica–LowLevelHardware

El tema de la disipación térmica y la transmisión de calor en las interfases heterogéneas de un disipador de procesador actual podría dar para muchos artículos.

Aquí solamente pondré un ejemplo práctico de un efecto que ocurre con frecuencia con las pastas térmicas tras un periodo prolongado de uso que incluya ciclos de encendido - apagado.
Al aplicar la pasta térmica, con más o menos pulcritud y corrección según el procesador que tengamos entre manos, debemos prestar atención a varios puntos:

No es lo mismo un die desnudo (Pentium III, Athlon Thunderbird, Duron, Athlon XP, CPUs de portátil ...) que uno con heat spreader (Pentium 4, Pentium D, Core 2, Athlon64, Phenom ...).

Poner la pasta sobre los cores o núcleos del procesador.

Si el disipador es de calidad y su superficie lisa y sin rayas (pulida) poner la menor cantidad de pasta e ir incrementando en función de la irregularidad de la superficie.

En este caso, el procesador es un quad core Core 2 Quad Q6600 (hand picked, V nominal 1,20 V) a 3.2 GHz @ 1.35Vcon FSB 1.6 GHz y dual channel DDR2 800 4-4-4-12 @ 2.0 V.


Pump out sobre la zona que ocupan los dos dies Core2Duo.

Podemos ver dos "claros" que marcan donde están los dos dies Core2Duo que componen un Core2Quad.

Este efecto se denomina pump out y describe como la pasta térmica debido a los ciclos de calor - frío y expansión - contracción del IHS (integrated heat spreader) del procesador es expulsada de la zonas más calientes.

PIC01357

PIC01356

La pasta sale de las zonas críticas produciendo un dry out (secado) y subida de temperatura, y en caso extremo un fallo de algún core de la CPU.

Etiquetas de Technorati: ,,

Si consideras útil el contenido de este Blog, ayuda a mantenerlo ojeando algunas de las ofertas que consideres interesantes de nuestros anunciantes. Gracias de antemano.

El que tenga dudas o aportaciones tiene para ello la sección de comentarios, intentaré responder a todos y con la máxima claridad. Los Blogs deben de ser lugares de intercambio y agradezco vuestro feedback.

domingo, 18 de mayo de 2008

El TLB secreto de AMD. Parte III.

En los dos artículos anteriores (1, 2) hemos introducido la existencia de una estructura oculta, no documentada en las controladoras de memoria integradas en los procesadores AMD K8 y K10. En este artículo analizaré 3 procesadores, dos A64 X2 AM2 y el Phenom 9600 BE con el TLB patch activado y sin el.

Controladora de memoria de 128 bit DDR de un AMD A64 939 130nm.


Controladora de memoria de 128 bit DDR de un AMD A64 X2 939 90nm.
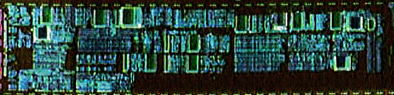

Controladora de memoria de 128 bit DDR2 de un AMD A64 AM2 65nm.


La motivación de esta serie de artículos es conocer más a fondo el comportamiento de las controladoras de memoria integradas de los procesadores AMD, gracias a su integración en el procesador han obtenido ventajas competitivas importantes y han podido mantener en el mercado arquitecturas obsolescentes (léase K8 Athlon64) frente a los nuevos y más depurados núcleos de la serie Core2 de Intel.

Sistemas probados:

Sistema AM2:

  • Placa Gigabyte MA-790X DS4 R1.0 AM2+
  • 1 x 2 GB DDR2 800 5-6-6-18 Kingston HyperX
  • AMD A64 X2 5600+ Brisbane G2, 65 nm, 2.9 GHz, 2 x 512 KB L2
  • AMD A64 X2 5600+ Windsor F2, 90 nm, 2.8 GHz, 2 x 1024 KB L2

Sistema AM2+:

  • Placa Gigabyte MA-790X DS4 R1.0 AM2+
  • 2 x 1 GB DDR2 1066 @ 800 4-4-4-12-1T Kingston HyperX
  • AMD Phenom 9600 Barcelona B2, 65nm, 2.3 GHz, 1.8 GHz NB, 4 x 512 KB L2, 2048 KB L3
  • Con el TLB BIOS Patch aplicado y sin él.

Para mayor información sobre el TLB patch, errata 298 y los stepping B2 y B3 de AMD Barcelona recomiendo leer este artículo anterior.

Resultados experimentales


Todos los resultados y gráficas obtenidos con el software RMMA 3.8, descarga.


RightMark Memory Analyzer 3.8.

Athlon64 X2 5600+ Windsor, F2, 90 nm, 2.8 GHz, 2 x 1 MB L2

D-TLB test de 16384 entradas. Tamaño tercer D-TLB 16384 entradas.

Test I-TLB de 16384 entradas. Tamaño tercer I-TLB 16384 entradas.

L2 D-TLB miss latency: sobre 38 ciclos.

Tercer nivel D-TLB miss latency: más de 100 ciclos. Tamaño estimado 16384 entradas.

L2 I-TLB miss latency: sobre 40 ciclos.

Tercer nivel I-TLB miss latency: más de 280 ciclos. Tamaño estimado 16384 entradas.

Athlon64 X2 5600+ Brisbane, G2, 65 nm, 2.9 GHz, 2 x 512 KB L2

Test D-TLB de 16384 entradas. Tamaño tercer D-TLB 8192 entradas.

Test I-TLB de 16384 entradas. Tamaño tercer I-TLB 8192 entradas.

L2 D-TLB miss latency: sobre 42 ciclos.

Tercer nivel D-TLB miss latency: más de 260 ciclos. Tamaño estimado 8192 entradas.

L2 I-TLB miss latency: sobre 56 ciclos.

Tercer nivel I-TLB miss latency: más de 340 ciclos. Tamaño estimado 8192 entradas.

AMD Phenom 9600 Barcelona B2, 65nm, 2.3 GHz, 1.8 GHz NB, 4 x 512 KB L2, 2 MB L3 sin TLB BIOS Patch

Test D-TLB de 16384 entradas. Tamaño del tercer D-TLB 8192 entradas.

Test I-TLB de 16384 entradas. Tamaño tercer I-TLB 4096 entradas.

L2 D-TLB miss latency: sobre 52 ciclos.

Tercer nivel D-TLB miss latency: más de 100 ciclos. Tamaño estimado 8192 entradas.

L2 I-TLB miss latency: sobre 68 ciclos.

Tercer nivel I-TLB miss latency: más de 150 ciclos. Tamaño estimado 4096 entradas.

AMD Phenom 9600 Barcelona B2, 65nm, 2.3 GHz, 1.8 GHz NB, 4 x 512 KB L2, 2 MB L3 con TLB BIOS Patch

Test D-TLB de 16384 entradas. El tercer D-TLB ha perdido su eficacia.

Test I-TLB de 16384 entradas. El tercer I-TLB ha perdido su eficacia.

L2 D-TLB miss latency: sobre 387 ciclos.

Tercer nivel D-TLB miss latency: más de 460 ciclos. Tamaño estimado 8192 entradas.

L2 I-TLB miss latency: sobre 414 ciclos.

Tercer nivel I-TLB miss latency: más de 460 ciclos. Tamaño estimado 8192 entradas.

Conclusiones y comentarios

Como podemos ver en los gráficos y en los resultados hay tres hechos importantes a señalar:

  • Los A64 X2 del antiguo core Windsor de 90 nm son más rápidos y eficientes en relación a la memoria (y tambien con la caché L2). Sus miss penalties (latencia acumuladad en caso fallo del TLB) son siempre menores, a veces 3 veces inferiores.
  • Los Phenom stepping B2 sufren una brutal degradación en su velocidad y latencia de memoria debido a una gradísima penalización en caso de fallo de sus L2 TLBs.
  • Por último queda demostrada la existencia de una estructura a modo de gran TLB o tercer nivel TLB, tanto para instrucciones como datos y que mitiga la penalización en caso de fallo de los L2 TLBs. Su tamaño es variable, entre 4K entradas y 16K entradas según las pruebas.

Como comentario final, puntualizar que el TLB Patch disminuye la eficiencia de este gran TLB prácticamente a cero, provocando miss penalties en el entorno de los 400 (!!) ciclos de CPU en caso de fallo de los L2 TLB.

Parece demostrado que el fallo que provoca la errata 298 está localizado físicamente en esta estructura oculta localizada en la controladora de memoria integrada.

Podemos decir que por fortuna AMD ha tardado poco en ultimar y comercializar su core Barcelona B3, libre ya del infame TLB bug o errata 298. Recordemos que los primeros diseños de Shanghai 45 nm también poseen este defecto y AMD ha tenido también que modificarlos y ello retrasará en alguna medida su time to market.

Para una descripción de la arquitectura del AMD Phenom, consulte este artículo.

Pra un análisis y discusión de errata 298 y los stepping B2 y B3, consulte este enlace.